

INTRODUCTION
Les recherches en prosodie – et de manière plus générale, les travaux en phonétique et en phonologie – se font presque toujours à partir d'enregistrements (audio ou vidéo) qui peuvent être analysés acoustiquement. Quels que soient les objectifs de recherche visés – construction de modèles pour rendre compte du fonctionnement intonatif ou accentuel d'une langue (cf., entre autres, Di Cristo, ce volume); étude de la réalisation phonétique d'une catégorie prosodique particulière (cf., par exemple, Portes, Reference Portes2004) etc.) – et quel que soit le type des données utilisées (lecture oralisée d’énoncés, entretiens guidés, etc.), l’étape de transcription est inévitable. Cette transcription – qui suppose généralement une segmentation – propose une représentation symbolique du message linguistique produit, représentation faite soit en utilisant l'orthographe standard, soit à l'aide de l'API (alphabet phonétique international). Elle s'accompagne aussi fréquemment d'un codage visant à représenter les aspects prosodiques plus particulièrement étudiés. Ainsi, par exemple, pour les faits intonatifs, plusieurs codages ont été utilisés, la majorité reposant sur une segmentation en syllabes.
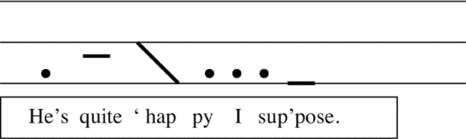
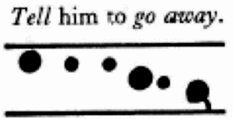
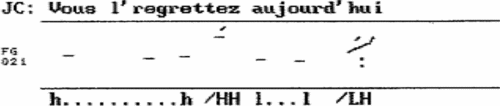
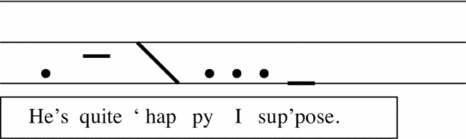
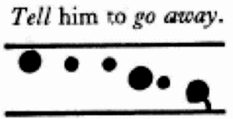
(1) Quelques exemples de systèmes de notation utilisés pour représenter l'intonation
a Représentation utilisée pour l’énoncé He's quite happy, I suppose par Jones, Reference Jones1972 (cf. Ali, Reference Ali2010: 52)
b Représentation utilisée pour l’énoncé Tell him to go away par O'Connor et Arnold, Reference O'Connor and Arnold1961. (cf. Ali, Reference Ali2010: 57)
c Système de notation utilisé pour l’énoncé Vous le regrettez aujourd'hui par Mertens, Reference Mertens1987. Il comprend une notation graphique et un codage alphanumérique.
Ces codages sont généralement faits sur des bases perceptives. A l'exception du codage alphanumérique en (1c), ils ne sont pas facilement lisibles et interrogeables pour une utilisation dans des corpus numériques.
Notation de Jones pour indiquer un contour descendant suivi d'une parenthèse basse
Notation utilisée par O'Connor et Arnold, Reference O'Connor and Arnold1961
Système de notation utilisée par Mertens, Reference Mertens1987, pour représenter l'intonation
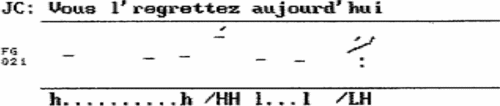
Force est de constater que les codages proposés pour représenter les aspects prosodiques sont souvent élaborés par chaque chercheur individuellement ; ils sont donc difficilement utilisables pour échanger des données, ou pour construire et évaluer des modèles prosodiques. En effet, il n'existe pas, à notre connaissance, de systèmes de transcription communément admis pour représenter les faits prosodiques, et cela malgré des tentatives notables pour en développer. Il est difficile de comprendre pourquoi, mais plusieurs éléments peuvent en partie expliquer ce manque:
- dans sa définition même, la prosodie englobe des phénomènes variés (accentuation, intonation, etc.) qui se manifestent sous différentes formes dans le signal (fréquence fondamentale, intensité, durée). Pour proposer une transcription des faits prosodiques, il faut déterminer ce qui doit être représenté et comment cela doit l’être.
- choisir les symboles puis les unités de segmentation auxquelles les assigner n'est pas aisé, les faits prosodiques étant pour une bonne part gradiants et donc difficiles à discrétiser.
Selon nous, un système de transcription constitue cependant un atout important et nécessaire pour le partage et la description des données, voire même pour la construction de modèles grammaticaux rendant compte de l'accentuation ou de l'intonation du français (ou d'autres langues). Aussi, afin d'avancer vers le développement d'un tel système, nous nous proposons ici de poser des jalons qui pourraient servir de bases à sa construction. Nous le faisons en nous référant à l'API, dans la mesure où ce système, quoique critiquable sous certains aspects, est communément utilisé. Nous procédons donc à des allers-retours entre l'API et certains systèmes de transcription de la prosodie.
Dans un premier temps, après avoir expliqué en quoi consiste la tâche de transcription, nous présentons les caractéristiques essentielles de l'API et tentons de voir comment les transposer pour développer un système de transcription de la prosodie. A partir de là, nous proposons une analyse critique de plusieurs systèmes existants, et essayons de voir quelles pistes seraient les plus intéressantes pour aller vers un consensus dans la façon de transcrire les faits prosodiques. Les exemples utilisés pour ce travail sont en grande partie extraits du corpus PROSO_FR (cf. Avanzi et Delais, ce volume); mais nous avons également travaillé sur des productions orales d'apprenants de français langue étrangère, lesquelles peuvent s'avérer plus délicates à transcrire, car plus éloignées des données de français standard.
1 DE LA RÉALITÉ DU SIGNAL SONORE À SA TRANSCRIPTION
Toute production langagière – qu'il s'agisse d'une conversation dialoguée, d'une lecture de texte ou d'une présentation monologuée – correspond à une séquence sonore. Cette dernière comprend des événements sonores qui peuvent être analysés comme des faits physiques concrets et quantifiables. Mais, pour en extraire les événements linguistiquement pertinents, un effort d'abstraction et d'analyse est nécessaire. En effet, le signal sonore renferme des éléments de nature linguistique (comme les sons correspondant à des voyelles et des consonnes, comme des pauses pouvant indiquer des frontières entre groupements prosodiques), mais il fournit également des informations extra-linguistiques (comme l’âge, le sexe, voire l’état d'esprit du locuteur). La difficulté de toute analyse réside donc dans le fait que ces différents éléments sont entremêlés et doivent être séparés les uns des autres.
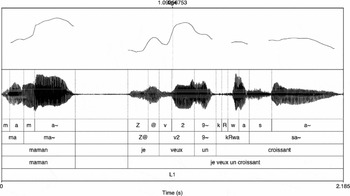
Deux autres types de difficultés sont à prendre en considération. Premièrement, les éléments linguistiquement pertinents observés dans l'onde sonore ne sont pas directement associables à une fonction linguistique. En effet, il n'existe pas de relation un-à-un entre un événement phonétique présent dans le signal et une fonction linguistique. Deuxièmement, toute onde sonore se déroule sur l'axe temporel, et des éléments distincts interviennent en parallèle si bien qu'un même intervalle temporel renferme à la fois des événements segmentaux comme les suites de segments, et des événements prosodiques comme des montées et des descentes mélodiques. Comme on le voit dans la figure 4 associée à l'exemple (2), des sommets mélodiques sont atteints au milieu des syllabes [m ] de maman et [vø] de veux ; ils sont donc réalisés en même temps que les sons [] et [ø] sont produits.
(2) Maman, je veux un croissant. (Corpus For-Dia, PROSO_FR)
Figure 4.Représentation de l’énoncé Maman, je veux un croissant (For-Dia)


Malgré ces difficultés, le signal sonore doit être représenté pour être analysé linguistiquement. Dans cette section, nous réfléchirons à la façon de construire une telle représentation. Nous le ferons en nous appuyant sur le système de transcription utilisé pour les faits segmentaux, l'API.
1.1 La transcription comme représentation linguistique du signal sonore
Représenter ce qui est linguistiquement pertinent dans une onde sonore consiste à proposer une transcription de cette onde (cf. Llisterri, Reference Llisterri1994). Mais, cette tâche suppose que nous sachions ce qui est linguistiquement pertinent dans le signal sonore. Comme première approximation, on peut considérer que ‘le linguistiquement pertinent’ est intimement lié à la signification du message, et donc à son interprétation par le transcripteur. Une transcription doit donc contenir toutes les informations se manifestant dans la face sonore et qui sont nécessaires pour pouvoir interpréter le message. Dès lors, une transcription comprend au moins les segments réalisés par les locuteurs, tout signe linguistique étant dans sa dimension acoustique au moins une séquence de sons. Mais, dans certains cas, et surtout dans certaines langues, des éléments de nature prosodique doivent aussi être donnés dans les transcriptions, dans la mesure où ils interviennent dans la construction des images acoustiques associées aux unités lexicales. Ainsi par exemple, en japonais, la position de l'accent mélodique montant permet de distinguer le mot baguettes du mot pont.
(3) hási: baguettes
hasí: pont
Au vu de cette définition de la tâche de transcription, on comprend qu'il n'est vraiment possible de transcrire qu'une langue donnée à l'avance. La tâche de transcription consiste alors à assigner une étiquette à chaque son ou élément prosodique produit, mais le choix de l’étiquette étant en partie déterminée par la langue à transcrire. Dès lors, une transcription se situe déjà à un niveau proche du niveau phonémique, même lorsque les variantes allophoniques sont notées.
1.2 L'API ou la représentation de la dimension segmentale
Pour transcrire les séquences de segments associées aux énoncés, les linguistes utilisent très fréquemment l'API (alphabet phonétique international). Il s'agit d'un système de transcription développé en 1888 par des phonéticiens et des enseignants de langues français et britanniques, sous les auspices de l'Association Phonétique Internationale (cf. Handbook of the IPA, 1999). Ce système permet de représenter tous les segments sonores des langues du monde en utilisant un ensemble limité de symboles, dans le but de faciliter l'apprentissage de la prononciation dans une langue étrangère. D'après cet objectif de base, trois caractéristiques essentielles de l'API peuvent être mises en avant:
(i) le nombre de symboles est limité (en l'occurrence 108 symboles de base);
(ii) le système n'a pas été développé pour une langue donnée, mais bien pour transcrire toutes les langues, voire toutes les variétés;
(iii) les symboles sont assignés à des segments, ce qui suppose une segmentation du flux sonore en segments.
Ces caractéristiques doivent favoriser le partage des données, mais aussi l'adéquation entre transcripteurs. De plus, cela doit permettre les comparaisons entre langues, voire entre variétés d'une même langue, des symboles distincts étant assignés à des segments phonétiques différents.
Dans les faits, le système n'est pas indépendant des langues. Tout d'abord, un même symbole ne renvoie pas à la même réalité acoustique et phonétique, selon la langue dans laquelle il est utilisé. On observe en effet une adaptation langue par langue. Ainsi, le symbole [p] est utilisé pour transcrire l'occlusive bilabiale non voisée aussi bien pour le français que pour l'anglais, même si d'un point de vue auditif et acoustique, les deux sons sont différents, la consonne étant plus aspirée en anglais qu'en français. Cela montre à quel point la notion de contraste est importante et qu'on se situe déjà à un fort niveau d'abstraction. Deuxièmement, comme mentionné dans la section 1.1, toute transcription suppose en quelque sorte une interprétation du message, et est donc de fait dépendante d'une langue donnée.
Malgré ces limitations, l'API est largement utilisé, et sert souvent de base pour l’échange et l'analyse de données linguistiques. Trois éléments contribuent à expliquer cet état de fait. Premièrement, en représentant le continuum sonore comme une séquence de segments, l'API adopte une façon de représenter le flux de parole très intuitive qui se retrouve d'ailleurs dans les fondements de l’écriture orthographique, où chaque graphème simple ou composé (digramme ou trigramme) correspond à un phonème (cf. Catach, Reference Catach1995). Deuxièmement, le segment constitue un lieu de contraste, et est donc une unité de segmentation fondamentale pour représenter les aspects de la parole linguistiquement pertinents, et seulement ceux-là. Troisièmement, l'API, en utilisant le segment comme unité de base, permet d'effectuer des transcriptions plus ou moins précises selon qu'on se situe à un niveau phonémique ou à un niveau phonétique. De fait, tout segment représenté par un symbole de l'API n'est pas nécessairement un phonème. Prenons l'exemple sous (4) extrait du corpus For-Lec (PROSO_FR).
(4) C'est parti pour sa quatrième campagne présidentielle. (For-Lec)
a. Représentation phonétiqueFootnote 1: [sɛ paxti puχ sa chatxijmə kɑ˜paɲə pxɛzidɑ˜sçlə]
b. Représentation phonémique: /sɛ paʁti pur sa katʁijɛm kãpaɲ prezidãsjɛl/
(4a) représente, à l'aide de l'API, les différents sons effectivement produits par le locuteur. Parmi eux, certains ne sont pas des phonèmes du français ; ils représentent simplement des variantes de réalisation. Ainsi, le /ʁ/ de parti est prononcé comme un fricative vélaire, et non comme une uvulaire. De même, l'occlusive /k/ de quatrième est produite comme une occlusive dorso-palatale aspirée. (4b), en revanche, propose une transcription phonémique de l’énoncé.
Les transcriptions proposées sous (4), aussi fines soient-elles, ne correspondent pas à la réalité du signal. Cependant, deux points apparaissent clairement:
(i) la transcription suppose une discrétisation du signal de parole, par nature continu ;
(ii) les unités ou segments choisis pour discrétiser le signal correspondent à des lieux de contrastes ou d'oppositions phonologiques possibles. Ainsi, pour c'est, le son [s] peut contraster avec [t] (t'es parti), etc. Si, en changeant un segment phonétique par un autre (c'est-à-dire un symbole par un autre), on obtient une séquence ayant une signification différente, les deux sons entrent en opposition, et constituent des variantes de deux phonèmes distincts.
Pour synthétiser, l'API comme système de transcription présente des caractéristiques importantes: il repose sur l'idée (i) que le flux de parole peut être analysé comme une suite de segments, (ii) que les segments sont des unités relativement neutres sur le plan théorique, mais correspondant aux positions de contrastes et d'oppositions possibles ; (iii) que l'ensemble d’étiquettes ou de symboles retenus est assez limité (malgré l'usage des diacritiques); (iv) que chaque symbole doit correspondre à un son, et à un seul; et (v) que le continuum sonore peut être représenté à un niveau plus ou moins asbtrait. Voyons maintenant comment ces caractéristiques peuvent être adaptées pour transcrire les phénomènes prosodiques.
1.3 Transposition vers la prosodie et ses différents domaines
Pour transcrire les faits prosodiques, il est nécessaire de déterminer parmi les caractéristiques suprasegmentales lesquelles sont linguistiquement pertinentes, cette tâche constituant un préalable à la définition des unités de segmentation et au choix des symboles. Mais, deux difficultés majeures doivent être prises en considération, et ont sans doute largement contribué à freiner le développement d'un système de transcription de la prosodie. Tout d'abord, sur le plan théorique, la définition du «linguistiquement pertinent» en prosodie est très problématique. En effet, le statut phonologique des faits suprasegmentaux de niveau postlexical a très souvent été sujet à discussion, notamment suite à la position de la linguistique structurale de considérer la prosodie comme hors de son champ d'investigation (cf., entre autres, Martinet, Reference Martinet1956 et Reference Martinet1961). Ensuite, pour transcrire les faits prosodiques, il est nécessaire de tenir compte de leur diversité. Un ensemble restreint de symboles n'est sans doute pas suffisant pour rendre compte à la fois des groupements prosodiques, de l'accentuation et de l'intonation. Or, tout système doit être capable de représenter ces différents éléments.
Il est aisé de répondre point par point à ces deux difficultés. Pour ce qui est du statut phonologique, et donc linguistiquement pertinent, de certains traits prosodiques non distinctifs au niveau lexicalFootnote 2, étudions deux exemples précis.
(5) Segmentation prosodique, accentuation et opposition phonologique
a.
b.
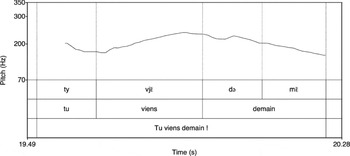
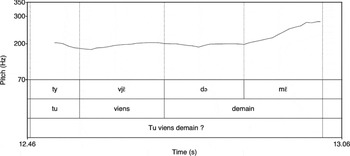
(6) Intonation et interprétation de l’énoncé
a. Tu viens demain !
b. Tu viens demain ?

En (5) comme en (6), l'opposition entre les deux énoncés a et b se fait sur des traits suprasegmentaux, et non sur les segments eux-mêmes. Dans les deux exemples, les deux énoncés reçoivent une transcription phonémique semblable. En (5), l'opposition entre les énoncés (5a) et (5b) est marquée par un découpage prosodique différent, et donc pas une localisation distincte de l'accent final. En (5a), l'accent final, lié à un frontière de groupe accentuel, est associé à la syllabe [gaʁ], alors qu'il est associé à la syllabe [s ] en (5b). De même, en (6), les contours mélodiques associés aux énoncés sont différents. En (6a), il est descendant, en particulier sur la séquence demain. En (6b), en revanche, le contour est montant, avec une montée mélodique réalisée plus particulièrement sur la syllabe finale [m
 ].
Contour descendant, à valeur jussive, réalisé sur l’énoncé tu viens demain

Contour montant, à valeur interrogative, réalisé sur l’énoncé tu viens demain

Ces deux exemples laissent clairement apparaître les deux difficultés qui doivent être prises en considération pour tout développement d'un système de transcription de la prosodie. Tout d'abord, les symboles retenus doivent rendre compte de l'accentuation, de l'intonation et des groupements prosodiques, et cela en tentant de rester le plus neutre possible sur le plan théorique. D'autre part, les unités auxquelles les symboles choisis sont assignées peuvent difficilement être les mêmes pour traiter de l'accentuation et de l'intonation. En (6a) par exemple, la descente mélodique est associée à un domaine plus large que la seule syllabe finale.
2 ANALYSE CRITIQUE DES SYSTÈMES EXISTANTS
Dans les sections qui suivent, nous allons proposer une analyse critique de plusieurs systèmes d'annotation prosodique qui sont fréquemment utilisés pour les données du françaisFootnote 3, mais nous conservons aussi deux systèmes plus généraux, utilisés dans de nombreuses langues, l'extension prosodique de l'API et ToBi (cf. Jun, Reference Jun2005).
Après une description des systèmes qui fournira des informations sur les symboles utilisés, les phénomènes prosodiques représentés et les unités de segmentation retenues, nous nous attarderons sur les choix faits en matière de segmentation et d’économie des symboles. Dans l'analyse, nous devons garder en mémoire que, pour offrir des avantages similaires à ceux observés dans l'API, tout système de transcription de la prosodie doit permettre (i) de reconstruire aussi bien le fonctionnement accentuel que le profil mélodique; (ii) de représenter les éléments sans savoir à priori s'il s'agit de catégories phonologiques, ou simplement d’événements phonétiques. Autrement dit, le système doit être à la fois descriptif – permettant de prendre en compte toutes les formes et variations possibles – mais aussi suffisamment contrastif pour faire émerger les catégories phonologiques de la prosodie.
2.1 l'API et la transcription des faits prosodiques
L'alphabet phonétique international propose une série de signes pour transcrire les faits prosodiques. Parmi eux, certains sont destinés à représenter les informations prosodiques de niveau lexical, lesquelles interviennent dans le marquage des oppositions phonologiques dans les langues à accent, dans les langues à tons, etc. Mais, une série de symboles est plus précisément consacrée à l'encodage des informations prosodiques de niveau phrastique.Footnote 4 Les unités prosodiques sont représentées à l'aide des symboles « | » et « ‖ ». Le symbole « | » note les frontières de groupes mineurs et le symbole « ‖ » celles des groupes majeurs. L'accentuation métrique (ou pragmatique) peut être représentée à l'aide des symboles « ˈ » et « ˌ » associés respectivement aux syllabes portant un accent primaire et à celles portant un accent secondaire. Quant à la courbe intonative associée à un énoncé, elle peut être représentée à l'aide des symboles indiquant les downsteps (↓), les upsteps (↑), les montées globales (↗) et les chutes globales (↘). En général, ces symboles sont notés avant la syllabe sur laquelle se produit le mouvement mélodique ou le changement de registre. Ils portent sur l'ensemble de l'unité mineure, voire de l'unité majeure. Considérons l'exemple (7) extrait de la lecture oralisée (For-Lec) dans le corpus PROSO_FR. Dans la transcription retenue, les symboles mélodiques sont attribués aux syllabes portant un accent primaire et réalisées à la fin des unités mineures.
(7) Mais, en même temps, il donne le sentiment d'avoir cédé à la pression ambiante.
↗ ’mE ‖ mEm ↗ ‘t ‖ il dɔn lə ˌs ti ↗ ’m | da vwaʁ se ↗ ‘de ǀ a la pʁe ↗ ‘sj ǀ ↗ ’bjt ‖
Ce sytème de notation offre plusieurs avantages. D'une part, il permet d'encoder de nombreuses informations prosodiques, qu'elles soient liées au phrasing, à l'intonation ou à l'accentuation. De plus, ces informations sont notées indépendamment les unes des autres. D'autre part, l'encodage des faits intonatifs peut se faire au niveau phonétique, sans présager de l'analyse phonologique qui en découle. Plusieurs points sont cependant problématiques. Tout d'abord, pour l'accentuation, la notation retenue est semblable à celle utilisée pour l'accentuation lexicale. Cela peut donc prêter à confusion quant au statut de l'accent dans la langue à transcrire. Il est évident, par exemple, qu'en français, les notations des accents se feront sur une opposition entre accent initial et accent final, sans qu'on puisse réellement dire si l'accent final est primaire, l'initial secondaire (cf., sur ce point: Di Cristo, ce volume; Astesano, Reference Astésano2001). Ensuite, rien n'est dit sur les modalités d'attribution des étiquettes relevant de l'intonation: les mouvements mélodiques portent-ils sur l'ensemble du domaine prosodique, sur un groupe de syllabe, sur une seule syllabe, voire sur une frontière de constituant ? Comment ces différences doivent-elles être encodées ? Pour finir, le problème majeur repose sur la question de la segmentation et de la formation des unités prosodiques. Aucune information précise n'est fournie sur les modalités de construction des unités mineures et majeures. La segmentation en unités donnée pour le texte lu dans le Handbook of the IPA est une bonne illustration de l'absence de consensus. Chaque auteur retient en effet des indices distincts, et cela même pour transcrire un texte lu. Pour les uns, l'unité tonale majeure correspond à la phrase écrite (cf. (8a)), tandis que pour d'autres, elle correspond à une unité (souvent marquée à l’écrit par un point ou une virgule) et s'achève par un contour continuatif (cf. (8b)).
- (8)
a. La tramuntana i el sol es disputaven, | sostenint cada u que ell era el mès fort, | quan de sobte, | veuen un viatger qui s'acosta embolicat en una gran capa. ‖Footnote 5
b. La bise et le soleil se disputaient, ‖ chacun assurant qu'il était le plus fort. ‖ Quand ils ont vu un voyageur qui s'avançait ‖ enveloppé dans son manteau ‖ etc.
2.2 Système de Piet Mertens
Piet Mertens (Reference Mertens, Blanche-Benveniste, Bilger, Rouget and Van de Eynde1990) propose un système de transcription de la prosodie basé sur la perception et ne reposant pas sur des présupposés théoriques très lourds. Pour les découpages prosodiques, il opère une distinction entre deux constituants, le groupe accentuel GA et le groupe intonatif GI. La différence entre ces deux groupes vient du fait que le GI est actualisé au niveau phonétique avec un marquage tonal et accentuel, alors que le GA est une construction abstraite. Cette dernière se construit à partir d'une opposition entre mot clitique et mot non-clitique. Sont non-clitiques les mots appartenants aux catégories suivantes (cf. Mertens et al., Reference Mertens, Goldman, Wehrli and Gaudinat2001): les verbes, les noms, les adjectifs, les adverbes (à l'exception de ne), les numérals (cinq, sixième, etc.), les mots phrases (oui, zut, etc.), les pronoms personnels toniques, les pronoms possessifs, les pronoms indéfinis, les pronoms interrogatifs (quoi, comment, etc.), les pronoms relatifs (à l'exception de que), les pronoms démonstratifs toniques, les déterminants indéfinis (aucun, chaque, etc.), etc. Sont regroupés dans un même GA un mot non-clitique et tous les mots clitiques qui en dépendent.
(9) tu prends le boulevard euh (.) là qui part de Nef Chavant là le boulevard qui passe à côté d'Habitat. (extrait de Infor-Iti, PROSO_FR)
a Segmentation en GA: (là) (qui) (part) (de Nef) (Chavant) (là) (le boulevard) (qui) (passe) (à côté) (d'Habitat.)
b Segmentation en GI: (là qui part) (de Nef Chavant) (là le boulevard) (qui passe à côté d'Habitat)
La transcription de l'accentuation se fait à partir d'une distinction entre deux types d'accents, l'accent final (noté AF) et l'accent initial (notée AI). Un accent final est obligatoirement réalisé sur la dernière syllabe de chaque groupe intonatif, alors que l'accent initial, réalisé en début de mot lexical, est facultatif. Dans la transcription, le marquage des syllabes accentuées se fait au moyen des symboles utilisés pour la représentation tonale, mais ces derniers sont en majuscules. L'ensemble des symboles est donné sous (10).
(10) Symboles utilisés pour la notation des traits accentuels et mélodiquesFootnote 6
En syllabe atone, on a: b, h, b-
En syllabe accentuée finale: BB, HH, HB, BH, B-B-, HB-, /BB, H/H, \HH, /BH . . .
En syllabe accentuée initiale: H, B
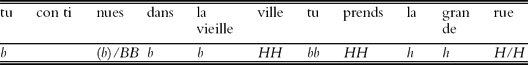
Dans ce système, les symboles sont attribués aux syllabes en s'appuyant sur les positions et non sur les syllabes elles-mêmes. On distingue trois types de position: la séquence de syllabes atones, les syllabes portant l'accent initial et les syllabes portant l'accent final. Pour les séquences atones, le début et la fin sont indiqués, si bien que l'encodage peut prendre la forme bb ou hh si la séquence se limite à une unique syllabe.
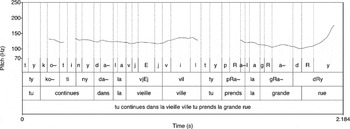
(11) Tu continues dans la vieille ville, tu prends la grande rue. (Infor-Iti)
codage associé à l’énoncé (11)
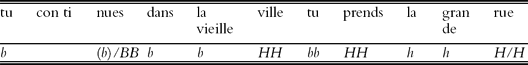
Contour mélodique associé à l’énoncé tu continues dans la vieille ville tu prends la grande rue (extrait de Infor-Iti, PROSO_FR)

Comme on le voit ici, le marquage proposé est abstrait et tente d'englober à la fois les informations accentuelles et intonatives. Ceci étant, si on se limite à l'inventaire proposé, le système fonctionne a un niveau phonologique et ne peut donc pas être utilisé pour une autre langue ou une variété du français. Deux raisons au moins à cela: d'une part, l'encodage suppose qu'une distinction soit faite entre différents types d'accents; d'autre part, les notations tonales sont choisies en fonction de l'inventaire des contours de base du français. Il est cependant possible de s'appuyer sur ce modèle pour construire un système plus souple, et, d'une certaine façon, plus proche de l'API. Il faudrait alors spécifier sur quelles bases se fait la sélection de l’étiquette tonale: les tons h et b sont-ils relatifs à ce qui précède et suit ? Sont-ils liés au registre du locuteur ?
Ce système se veut le plus possible indépendant d'une théorie linguistique. Pour gagner en indépendance, Mertens (Reference Mertens2004) propose d'utiliser le Prosogramme, un outil permettant d’établir une notation abstraite à partir d'une analyse automatique de la fréquence fondamentale et d'une stylisation de la courbe basée sur une estimation de l'intensité perçue. Les avantages de ce système de transcription sont nombreux. Tout d'abord, contrairement à la plupart des autres systèmes, il prend en compte des paramètres acoustiques autres que la fréquence fondamentale (la durée ou l'intensité). Par ailleurs, il repose essentiellement sur une segmentation en syllabes, ce qui peut permettre de préserver une objectivité dans la segmentation en unités auxquelles sont assignées les étiquettes.
2.3 IVTS
IVTS (acronyme pour: Intonational Variation Transcription System) est un système manuel de transcription de la prosodie qui a été développé dans le cadre métrique-autosegmental (cf. Pierrehumbert, Reference Pierrehumbert1980 et Ladd, Reference Ladd1996) et qui repose sur l'idée qu'il faut clairement distinguer le niveau phonologique du niveau phonétique pour analyser adéquatement les phénomènes prosodiques (cf., entre autres, Hirst, Reference Hirst, Di Cristo, Espesser and Horne2000 et Post et Delais-Roussarie, Reference Post, Delais-Roussarie, Simon, Caelen-Haumont and Simon2006). Ce système doit permettre d'encoder les variations intonatives et prosodiques pour établir des comparaisons entre langues, ou entre dialectes d'une même langue. Il repose sur une adaptation directe d'IViE (cf. Grabe et al., Reference Grabe, Post, Nolan, Puppel and Demenko2001 et Reference Grabe, Post, Sampson and McCarthy2004) et, en tant que système de représentation de l'intonation, il offre de nombreux avantages comparativement à des systèmes comme ToBI ou INTSINT qui seront présentés dans les sections 2.4 et 2.5: (i) étant conçus pour analyser les variations dialectales, aucune connaissance n'est présupposée quant au statut phonologique de tel ou tel événement prosodique (statut métrique des syllabes proéminentes, identité phonologique d'un mouvement mélodique, etc.); (ii) avec sa structure multilinéaire (l'encodage d'informations phonétiques, métriques et phonologiques se faisant sur plusieurs tires ou niveaux), il offre plus de transparence et de flexibilité; (iii) il peut facilement être adapté pour permettre l'encodage de phénomènes non locaux comme les changements de registre ou les downsteps.
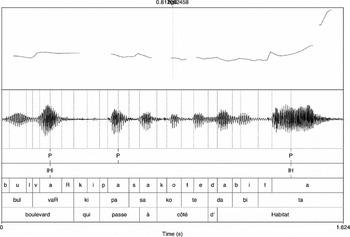
Dans le système IVTS, la transcription se fait sur cinq ou six tires: Commentaires, Mots, Phonologie, Perception phonétique locale, Proéminences et éventuellement Perception phonétique globale. Cela a un double avantage: d'une part, des informations perceptives, phonétiques et phonologiques sont intégrées dans les transcriptions; d'autre part, les phénomènes métriques peuvent être traités indépendamment des phénomènes intonatifs, notamment avec la tire proéminences. Ainsi par exemple, en (12), certaines syllabes sont perçues comme proéminentes sans pour autant porter un contour intonatif.Footnote 7
(12) là qui part de Nef Chavant là l(e) boulevard qui passe à côté d'Habitat (extrait de Infor-Iti dans PROSO_FR)
a. Figure 8: Représentation du signal et de la courbe de F0 associés à la séquence boulevard qui passe à côté d'Habitat dans l’énoncé sous (12)
b. Notation symbolique avec IVTS des proéminences et des mouvements mélodiques perçus pour l’énoncé boulevard qui passe à côté d'Habitat
Contour mélodique, signal et codage IVTS associés à l’énoncé boulevard qui passe à côté d'Habitat

Dans ce système, la transcription de l'intonation est conçue comme une succession de notations tonales associées aux syllabes proéminentes, et est donc une suite de points-cibles. Dans les faits, elle se construit à partir d'une distinction entre syllabe proéminente et syllabe non proéminente. En effet, la segmentation et l’étiquetage se font à partir d'une détermination des syllabes perçues comme proéminentes, le continuum ayant été au préalable segmenté en groupes prosodiques. Deux points dans le fonctionnement IVTS sont intéressants et méritent d’être mis en avant: (i) la tire tonale est dissociée de la tire proéminences; aussi est-il possible d'avoir des accents marqués par la durée, mais pas par l'intonation; (ii) la description tonale passe par la perception, la phonologie se construisant lors de l'analyse, grâce à la prise en compte des informations encodées dans les tires phonétiques. Cette façon de procéder est tout particulièrement valable lorsqu'on souhaite étudier des productions d'apprenants. La construction de la grammaire de l'apprenant peut se faire à partir des tires proéminence et perception phonétique locale.
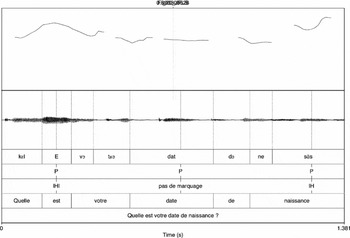
(13) Quelle est votre date de naissance?
a. Figure 9: Représentation du signal et de la courbe mélodique correspondant à (13)
b. Notation IVTS de l'exemple (13) produit par un apprenant
D'après cet exemple, on voit que le locuteur associe un mouvement tonal à la proéminence réalisée sur la copule est, mais qu'aucun mouvement intonatif n'est associé à la syllabe date. La mise en parallèle de cette réalisation avec d'autres réalisations du même locuteur pourrait nous indiquer si ce dernier n'associe pas de mouvements tonals aux syllabes de fin de groupe accentuel (comme pour quelle est votre date). On peut aussi étudier les mouvements choisis pour telle ou telle position métrique, pour ensuite en déduire une grammaire intonative.
Contour mélodique, signal et codage IVTS associés à l’énoncé Quelle est votre date de naissance?

Comme on peut le voir, IVTS présente des avantages; mais certains points nécessitent d’être approfondis car ils peuvent s'avérer problématiques. A l'heure actuelle, la construction des tires proéminence et perception phonétique locale passe par une segmentation du flux sonore en syntagmes intonatifs (ou IP). Il faut essayer de voir si le recours à des unités plus faciles à définir (comme, par exemple, les unités inter-pausales) serait envisageable. De plus, il est souvent délicat de déterminer les syllabes proéminentes; cela est en effet la source de gros désaccords entre transcripteurs. Peut-être serait-il intéressant de recourir à des systèmes semi-automatiques pour effectuer cette tâche (cf. Avanzi et al., ce volume).
2.4 ToBi et une proposition d'adaptation
ToBi (acronyme pour Tone and Break Indices) est un système de transcription qui a été développé à partir des travaux de Pierrehumbert, Reference Pierrehumbert1980 et de Pierrehumbert et Beckman, Reference Pierrehumbert and Beckman1988. Il a été adapté à de nombreuses langues (cf., entre autres, Jun, Reference Jun2005). Dans le système ToBi, la transcription de l'intonation se fait sur minimalement trois tires distinctes: une tire indiquant les indices de frontière entre items lexicaux (break indices), une tire tonale et une tire orthogarphique. De plus, toute transcription est conçue comme un balisage et s'accompagne d'une représentation du signal et de la courbe mélodique. A l'origine, les groupements prosodiques n’étaient pas notés en tant que tels, mais le codage des indices de frontières permettaient de déduire des groupes comme les mots prosodiques, les groupes accentuels et les groupes intonatives. En effet, un indice de frontière de valeur 0 indique une frontière entre un clitique et un mot non-clitique, un indice de valeur 1 une frontière entre deux mots lexicaux, un indice de valeur 3 une frontière entre deux groupes prosodiques mineurs (syntagme phonologique, etc.) et un indice de valeur 4 une frontière entre deux groupes intonatifs (cf., entre autres, Beckman et al., Reference Beckman, Hirschberg, Shattuck-Hufnagel and Jun2005). Comme la détermination des indices se faisaient partiellement sur des bases morpho-syntaxiques, un accord important existait entre transcripteurs. Dans les développements et les adapatations récentes (cf. Jun, Reference Jun2005), les indices de frontières sont liés à la structuration prosodique en syntagmes accentuels (accentual phrase), syntagmes intermédiaires (intermediate phrase) et syntagmes intonatifs (intonational phrase), cette structuration étant elle-même liée à des marquages tonals particuliers, notés dans les diacritiques accompagnant les tons.
(14) Marquage tonal et structuration prosodique dans ToBi
Syntagme accentuel (AP): pitch accent noté par le symbole *
Syntagme intermédiaire (ip): phrase accent noté par le symbole –
Syntagme intonatif (IP): boundary tone noté par le symble %
Cette symétrie entre les marquages tonals et la structuration ne va pas sans poser de problèmes, tout d'abord de circularité, et ensuite sur le statut des évenements tonaux (cf., entre autres, pour une critique intéressante de ces aspects, Hirst, Reference Hirst2005).
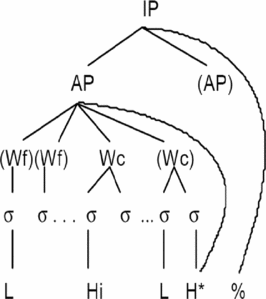
Pour le moment, il n'existe pas de système ToBi permettant de transcrire l'intonation du français. On pourrait néanmoins en proposer un à partir du modèle de l'intonation proposé par Jun et Fougeron, Reference Jun, Fougeron and Botinis2000. D'après ces auteurs, un énoncé peut être analysé sur le plan intonatif comme une succession de syntagme accentuels (AP pour accentual phrase), eux-mêmes regroupés en syntagmes intonatifs (IP pour intonational phrase). Le contour mélodique d'un énoncé est dérivé des «gabarits tonals» associés aux syntagmes accentuels, gabarits dont la forme phonologique de base est LHi LH*, le H* étant associé à dernière syllabe métrique du syntagme (c'est-à-dire la syllabe accentuée). Lorsque le groupe accentuel est en position finale de syntagme intonatif, un ton de frontière est également réalisé. L'ensemble du système est synthétisé dans la figure sous (15).
(15) Grammaire phonologique de l'intonation proposée par Jun et Fougeron, Reference Jun, Fougeron and Botinis2000.
Dans cette figure, les séquences Wf, Wc, AP et Hi renvoient respectivement aux termes mot grammatical, mot de contenu, syntagme accentuel et montée initiale.
Grammaire de l'intonation (Jun et Fougeron, Reference Jun, Fougeron and Botinis2000: 214)
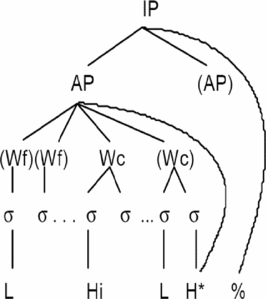
Dans ce modèle, au niveau sous-jacent, la séquence tonale LHi est réalisée à l'initiale des syntagmes accentuels, mais n'est pas associée à une syllabe proéminente. Elle correspond à une montée initiale. En revanche, la séquence LH* est associée aux deux dernières syllabes du syntagme accentuel, coïncidant avec une finale de mot lexical. Au niveau phonétique, il n'est pas rare que certains tons du gabarit sous-jacent ne soient pas réalisés, notamment lorsque le syntagme accentuel fait moins de quatre syllabes, ou lorsqu'il est en position finale d’énoncé.
En (16), l’énoncé extrait du dialogue Infor-Iti dans PROSO_FR (cf. aussi exemple (11) et fig. 7) peut être décomposé en deux syntagmes intonatifs, le premier étant composé de deux syntagmes accentuels, et le second d'un seul. La représentation sous-jacente associée est proposée en (16a), tandis que la réalisation tonale de surface est donnée sous (16b).
(16) Tu continues dans la vieille ville tu prends la grande rue (Infor-Iti)
a.
b.
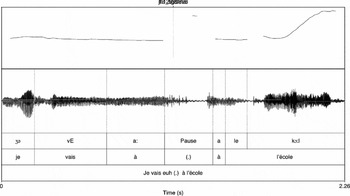
La réalisation tonale du second syntagme accentuel dans la vieille ville est de la forme L H*, les tons Hi et L n’étant pas associés, et donc pas réalisés. L'adaptation du modèle phonologique de Jun & Fougeron (Reference Jun, Fougeron and Botinis2000) pour effectuer des transcriptions suppose une segmentation du continuum en syntagmes accentuels et en syntagmes intonatifs, comme cela s'est fait pour le corpus du CID (Bertand et al., Reference Bertrand, Blache, Espesser, Ferré, Meunier, Priego-Valverde and Rauzy2008). Mais, plusieurs problèmes sont à noter. Tout d'abord, la définition du syntagme accentuel, bien que respectant quelques contraintes morpho-syntaxiques et lexicales, est fortement liée à la forme tonale qui lui est associée, ce qui peut s'avérer problèmatique, notamment dans des données non-standards ou dans certaines varitétés du français. De plus, cela risque de conduire à un manque d'accord entre transcripteurs. Ensuite, il est difficile de savoir comment et à quel niveau s'opèrent les modifications du gabarit tonal sous-jacent. En effet, lorsqu'un syntagme accentuel se voit attribuer un profil mélodique de la forme LH* ou de la forme LLH*, rien ne permet de savoir si cela va de pair avec une opposition phonologique, ou si LLH*, LHiLH* et LHH* constituent des variantes libres ou combinatoires d'un même contour au niveau phonologique. Pour finir, les relations entre H* et H% ne sont pas clairement spécifiées. Est-ce la position structurelle qui fait d'une montée mélodique un H* ou un H% ? Toutes ces difficultés apparaissent nettement lorsqu'on souhaite s'inspirer d'un tel système pour transcrire des données d'apprenants ou des variétés du français. En (17), par exemple, l’énoncé je vais à l’école est réalisé comme un seul syntagme accentuel, ayant, sur le plan tonal, une forme acceptable pour le français (LLH). Ceci étant, lorsqu'on l'entend, deux éléments posent problème. D'une part, le mot vais est réalisé sans marquage tonal, mais avec un allongement de la durée peu probable dans cette position. D'après Jun et Fougeron (Reference Jun, Fougeron and Botinis2000), un ton Hi est attendu sur la syllabe [vE] d'après le gabarit tonal abstrait LHiLH*, mais on n'a pas les moyens de savoir si sa non-réalisation est grammaticale ou non. D'autre part, la montée sur la syllabe finale de école dans l'exemple se réalise sur la seconde partie du noyau syllabique de [kɔl], un mouvement de type LH étant globalement réalisé sur l'ensemble de la syllabe, voire sur la coda ; or cela n'est pas possible dans ce contexte en français. L'appoche globale proposée ici, où les syllabes proéminentes et les modalités précises d'association tonale ne sont pas indiquées, ne permet pas facilement de faire ce genre de distinction, et de construire des grammaires intonatives.
(17) je vais euh à l’école (locuteur ND – entretien)
Représentation de la courbe mélodique et du signal associés à l’énoncé je vais à l’école.

Dans un tel système, les étiquettes retenues portent trop d'informations à la fois, et ne permettent pas clairement de faire des distinctions entre deux paires d’éléments: (i) les informations formelles (forme du contour, etc) et les informations d'ordre fonctionnel (rôle et position de tel ou tel contour dans la langue, lien avec les autres niveaux de description linguistique, etc.); et (ii) les faits accentuels et les faits mélodiques.
Selon nous, les difficultés rencontrées lorsqu'on adapte le modèle de l'intonation de Jun et Fougeron pour construire un système ToBi adapté au français ne sont pas imputables à l'adatation. Pour une part, elle résulte du système ToBi lui-même. Ce dernier a deux caracéristiques qui le distinguent fortement de l'API et qui peuvent poser problème pour en faire un standard pour la transcription des fais prosodiques:
- il est fortement lié à l'approche théorique proposée par Pierrehumbert et Beckman (Reference Pierrehumbert and Beckman1988) pour décrire l'intonation de certaines langues;
- il suppose généralement une connaissance du système phonologique tonal de la langue à transcrire, notamment pour encoder les différents événements tonals;
- il repose essentiellement sur une transcription des faits intonatifs, sans encoder distinctement les faits prosodiques de nature métrique se réalisant par des allongements syllabiques, etc.
2.5 Momel-Intsint
Le système Momel-Intsint propose une transcription de la courbe mélodique basée sur une séquence de points cibles déterminés par l'algorithme MOMEL, lequel décompose la courbe de fréquence fondamentale (Hirst et al., Reference Hirst and Espesser1993 et Reference Hirst, Di Cristo, Espesser and Horne2000). Des symboles issus de l'alphabet INTSINT sont ensuite attribués à chaque point cible. Ces derniers sont au nombre de huit.
(18) Symboles de l'alphabet INTSINT
a. symboles choisis en fonction du registre du locuteur: T (Top), M (Milieu) et B (Bottom);
b. Symboles exprimant des valeurs définies localement, relativement à ce qui précède: H (Higher), S (Same) et L (Lower), auxquels s'ajoutent deux symboles pour les changements de faible ampleur U pour Upstepped et D pour Downstepped.
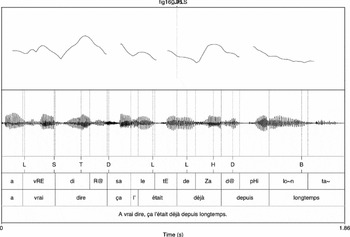
Sous (19), un codage effectué automatiquement avec Momel-Intsint est proposé. Seuls les points déterminés suite à une erreur de détection notable ont été corrigés ou supprimés.
(19) A vrai dire, ça l’était déjà depuis longtemps. (Corpus For-Lec, PROSO_FR)
a. Représentation symbolique de l’étiquetage
b. Figure 12: signal et F0 correspondant à l’énoncé sous (19)
Avec le système MOMEL-INTSINT, des points-cibles ont été placés sur des syllabes où des contrastes peuvent apparaître, comme par exemple sur les syllabes /diʁ/ dans dire, /ʒa/ dans déjà et /t/ dans longtemps. En revanche, certains points-cibles sont encodés sur des positions peu pertinentes linguistiquement comme, par exemple, la syllabe /le/ de l’était.
Représentation de la courbe mélodique et du signal associés à l’énoncé A vrai dire, ça l’était déjà depuis longtemps. (For-Lec)

D'une façon générale, le système Momel-Intsint offre de nombreux avantages: (i) il permet un codage symbolique de la courbe de fréquence fondamentale qui a l'avantage d’être fait automatiquement, et gagne donc en robustesse ; et (ii) le codage offre une bonne description de la forme de la courbe, sans faire d'hypothèses sur le fonctionnement phonologique de la langue. En revanche, plusieurs éléments posent probléme. Tout d'abord, l'encodage proposé permet surtout de représenter la courbe mélodique associée à un énoncé, mais on ne voit pas comment le phrasing et l'accentuation peuvent l’être. Il serait donc important de savoir si les points-cibles sont suffisants pour représenter les lieux de contrastes et construire des grammaires intonatives et accentuelles. A première vue, nous en doutons. Ensuite, les modalités d'assignation des symboles INTSINT supposent qu'il n'y ait pas de changement de registre dans la partie traitée (cela passe d'ailleurs souvent par une segmentation en groupes intonatifs). Il faut se demander si cela n'implique pas une segmentation particulière qui pourrait biaiser les résultats et l'analyse ultérieure.
3 CONCLUSION ET PERSPECTIVES
Plusieurs systèmes de transcription de la prosodie existent à l'heure actuelle. Mais force est de constater qu'ils sont loin de faire l'unanimité ! En opérant, pour les analyser, une mise en perspective qui parte de l'API, plusieurs éléments peuvent non seulement expliquer certaines difficultés, mais également ouvrir des perspectives. Les problèmes rencontrés dans les différents systèmes, même les plus intéressants et les plus proches de l'API sous certains aspects (cf. Mertens, Reference Mertens, Blanche-Benveniste, Bilger, Rouget and Van de Eynde1990 et séq.; Post et Delais-Roussarie, Reference Post, Delais-Roussarie, Simon, Caelen-Haumont and Simon2006 pour le système IVTS) s'articulent autour de trois points essentiels: la définition des unités de segmentation, le codage simultané des faits métriques et accentuels, le statut phonétique ou phonologique des événements.
En ce qui concerne les unités de segmentation, deux possibilités s'offrent au transcripteur: l'une d'elles consiste à choisir la syllabe comme unité puisqu'elle est souvent analysée comme l'unité de base pour la perception des faits prosodiques (cf. Segui, Reference Segui, Bouma and Bouwhuis1984) ; l'autre serait de s'appuyer sur une segmentation en unités plus larges, comparables à celles utilisées dans la hiérarchie prosodique (cf. Selkirk, Reference Selkirk, Aronoff and Kean1980, Pierrehumbert, Reference Pierrehumbert1980 et Ladd, Reference Ladd1996). Ceci étant, alors qu'il existe un consensus sur la syllabe, les unités plus larges ne reposent pas sur des critères robustes, et leurs définitions dépendent souvent de la théorie intonative sous-jacente. Un examen de différentes théories intonatives laisse apparaître deux approches dans la façon de définir les unités. Certaines s'appuient sur la réalisation intonative de ces dernières, et surtout sur la forme de leur contour terminal. D'autres prennent en compte la configuration syntaxique. Aussi semble-t-il préférable, en tous cas dans un premier temps, de prendre la syllabe comme unité de base.
En ce qui concerne l'encodage nécessaire des informations accentuelles et intonatives, l’étude des différents systèmes montre qu'il est difficile d'utiliser le même jeu de symboles pour tout encoder, comme cela est par exemple fait dans Mertens, Reference Mertens, Blanche-Benveniste, Bilger, Rouget and Van de Eynde1990. D'une part, il peut arriver qu'une syllabe soit accentuée et perçue comme proéminente, sans pour autant recevoir un marquage tonal spécifique. D'autre part, mais c'est plus rare en français standard, un événement tonal peut se produire sur une syllabe non accentuée, et marquer une frontière de groupement prosodique par exemple. Dès lors, dissocier marquage des proéminences et marquage tonal est important. Pour cela, un système fonctionnant sur plusieurs tires, à l'instar d'IVTS, de SAMPROSA ou de ToBi, est vivement souhaité. Dans cette perspective d'ailleurs, la syllabe apparaît comme l'unité fondamentale dans la mesure où elle reçoit les marquages accentuels et intonatifs, qu'ils se réalisent ou non sur des syllabes identiques.
En ce qui concerne les relations entre le phonétique et le phonologique, une démarche où l'encodage se fait syllabe par syllabe offre l'avantage de partir de la perception phonétique, sans nécessairement poser de catégories phonologiques, et inversement. Néanmoins, deux éléments doivent être l'objet de recherches ultérieures. D'une part, on peut se demander si, en tous cas au niveau phonétique, la détermination automatique des cibles-tonales et l'encodage de leur alignement à l'intérieur des syllabes, n'est pas une nécessité. Cela laisse en effet la possibilité que des différences d'alignement intra-syllabique aillent de pair avec des catégorisations phonologiques distinctes (cf., entre autres, Portes, Reference Portes2004; d'Imperio et Cangimi, Reference d'Imperio, Cangemi, Frota, Elordieta and Prieto2010). D'autre part, il est nécessaire de réfléchir sur le statut des constituants prosodiques comme le syntagme accentuel ou le syntagme intonatif, notamment afin de déterminer s'ils constituent des primitives phonologiques. Nous sommes en droit de nous demander s'ils doivent être définis et encodés dans la transcription phonétique, ou s'ils se déduisent des événements accentuels et tonals qui se réalisent sur des syllabes particulières. Si la définition de ces constituants est une nécessité, il faut se demander sur quelles bases cela doit être fait. Faut-il le faire à partir d'informations morpho-syntaxiques ? ou, au contraire, à partir d'indices acoustiques? Certains événements intonatifs sont-ils analysables et transcriptibles uniquement si des constituants prosodiques sont définis au préalable? Autant de questions auxquelles il faut trouver des réponses afin d'avancer vers un système qui puisse être partagé.
Pour finir, il est important de réfléchir à la robustesse des systèmes et à la possibilité d'obtenir un accord important entre transcripteurs. Dans cette perspective, certains systèmes offrent des pistes intéressantes. Tout d'abord, pour l'encodage des variations mélodiques, des outils comme Momel-Intsint peuvent proposer un pré-traitement robuste et assez neutre, qui peut ensuite être amélioré ou complété avec des systèmes comme IVTS. Pour cela, il faudrait cependant essayer de partir d'unités de segmentation neutres comme les unités inter-pausales. Pour les phénomènes comme l'accentuation, une détection semi-automatique des proéminences, en évitant le recours à des unités prosodiques larges, pourrait constituer un pré-traitement robuste (cf. Avanzi et al., ce volume et Mertens, Reference Mertens2004). D'une manière générale, les outils semi-automatiques offrent de nouvelles perspectives pour un premier encodage de la forme prosodique associée aux énoncés, encore faudrait-il que les connaissances sur lesquelles se fondent les détections des points-cibles et des proéminences soient le plus neutres possible. C'est pourquoi nous envisageons maintenant de tester la validité de ces outils et de l'unité inter-pausale en travaillant sur des données très diversifiées (lecture oralisé, présentation formelle, conversation, mais également parlers régionaux, parlers des apprenants, parole pathologique etc.).
REMERCIEMENTS
Les auteurs tiennent à remercier les participants à la journée CONSCILA, ainsi que les relecteurs anonymes, qui, par leurs commentaires, ont permis d'approfondir la réflexion présentée dans cette contribution.