

Introduction
En science politique, les premiers modèles prévisionnels fondés sur des indicateurs politico-économiques sont apparus entre le milieu des années soixante-dix et quatre-vingt (voir notamment Lewis-Beck et Rice, Reference Lewis-Beck and Rice1982; Reference Lewis-Beck and Rice1984a; Reference Lewis-Beck and Rice1984b; Reference Lewis-Beck and Rice1985; Rosenstone, Reference Rosenstone1983; Tufte, Reference Tufte1975; Reference Tufte1978). Depuis les quarante dernières années, le champ de la prédiction électorale s'est considérablement enrichi, mais la plupart des modèles qui se sont accumulés au fil du temps ont été élaborés pour les élections au Congrès ou à la présidence des États-Unis (Walther, Reference Walther2015: 1). Le Canada, à l'instar de la majorité des démocraties, n'a reçu jusqu’à maintenant que bien peu d'attention : on ne compte qu'un seul modèle visant à prédire les résultats du parti sortant aux élections fédérales canadiennes et, de l'avis même de ses concepteurs, ce modèle est loin d'atteindre les niveaux de précision obtenus pour d'autres États (Bélanger et Godbout, Reference Bélanger and Godbout2010: 696). Dans cet article, nous ferons d'abord le point sur les principales méthodes de prédiction avant de proposer un nouveau modèle prédictif pour estimer les scores du parti sortant lors des élections fédérales canadiennes. Des modèles de régressions apparemment indépendantes ou seemingly unrelated regressions (SUR) permettant d'obtenir des estimations pour plusieurs partis seront également mis à l’épreuve.
1. Les méthodes de prédiction
Lewis-Beck et Stegmaier (Reference Lewis-Beck and Stegmaier2014: 284) identifient trois profils de chercheurs dans le domaine de la prédiction électorale, à savoir les structuralistes (structuralists), les agrégateurs (aggregators) et les synthétiseurs (synthesizers)Footnote 1. Les structuralistes (par exemple, Lewis-Beck et Tien, Reference Lewis-Beck and Tien2016) utilisent des techniques de régression multiple afin de produire des modèles reposant sur une théorie du vote. La majeure partie de ces modèles sont conçus pour livrer une estimation du pourcentage des voix (ou des sièges) du candidat ou du parti en poste à l’échelon national et incluent généralement une combinaison de variables économiques et politiques. Ils offrent une prédiction unique (fixe) avec quelques mois d'avance. L'approche structurelle est l’une des plus couramment utilisées pour la réalisation de modèles prédictifs.
Pour leur part, les agrégateurs rassemblent des données de sondages d'opinion provenant de diverses sources. Plusieurs sites web procèdent aujourd'hui à l'agrégation des sondages réalisés par différentes firmes et différents médias : c'est notamment le cas de ThreeHundredEight (jusqu’à récemment) et de FiveThirtyEight ainsi que de RealClearPolitics et du HuffPost Pollster. L'agrégation permet de réduire l'erreur par l'annulation mutuelle des biais associés à chaque sondage pris séparément (Graefe, Reference Graefe2014: 206). Contrairement aux structuralistes, les agrégateurs ne proposent pas de théories du comportement électoral. En revanche, leurs prévisions sont dynamiques : des mises à jour sont possibles au fur et à mesure que sont conduits de nouveaux sondages.
Quant aux synthétiseurs (par exemple, Erikson et Wlezien, Reference Erikson and Wlezien2016), ils se situent quelque part entre les structuralistes et les agrégateurs. Leurs modèles prennent racine dans une théorie politico-économique du comportement électoral et se présentent sous une forme assez semblable aux équations structurelles, mais intègrent des résultats de sondages d'intention de vote. La prévision initiale peut donc être révisée tout au long de la campagne par l'intégration des résultats de sondages les plus récents (Lewis-Beck et Dassonneville, Reference Lewis-Beck and Dassonneville2015: 2).
Les modèles de régressions apparemment indépendantes ou SUR (voir Zellner, Reference Zellner1962) pourraient probablement former une catégorie à part entière, mais nous aurions tendance à les considérer comme une forme particulière de modèles structurels. Un système de régressions apparemment indépendantes permet d'obtenir un modèle à équations multiples en tirant profit de la corrélation des erreurs résiduelles de chaque équation. Comme l'indique Timm, « [t]he advantage of the SUR model is that it permits one to relate different independent variables to each dependent variable using the correlations among the errors in different equations to improve upon the estimators » (Reference Timm2002: 316). Le modèle SUR prend donc en considération la possibilité que les déterminants du vote pour un parti puissent également aider à estimer le vote pour d'autres partis. Si plusieurs équations (régressions linéaires) distinctes sont proposées pour chaque parti, alors il faut assumer que le terme d'erreur d'une équation (qui représente, pour simplifier, l'impact des facteurs pertinents omis de l'analyse) n'est pas corrélé avec le terme d'erreur des autres équations, ce qui risque de ne pas être le cas dans la réalité. Le modèle SUR tente de corriger ce problème en tenant compte des corrélations entre les erreurs des différentes équations.
En ce qui nous concerne, nous avons choisi de procéder d'abord à la création d'un modèle de type structurel afin de prédire la part des voix recueillies par la formation gouvernementale lors des élections fédérales canadiennes. Cette approche est celle qui convient le mieux au but de notre recherche, soit expliquer à travers la prédiction et non prédire aux dépens de l'explication. Bien que nous cherchions à établir un modèle d'une grande précision, la valeur théorique de ce modèle nous préoccupe néanmoins. Par conséquent, l'intégration de données de sondages d'intention de vote serait, à notre avis, hautement problématique dans la mesure où ce type d'enquêtes ne nous apprend presque rien sur les motivations des électeurs (en plus de faire dépendre en bonne partie la précision du modèle sur celle des sondages). Par ailleurs, au cours des dernières années, l'industrie du sondage a connu des ratés majeurs, à commencer par l’élection générale britannique de 2015, la victoire de Donald Trump l'année suivante et le résultat inattendu du référendum sur le BrexitFootnote 2. Le Canada n'est pas à l'abri de tels errements de la part des sondeurs : Coletto et Breguet (Reference Coletto and Breguet2015) ont par exemple souligné l'imprécision des sondages publiés dans la dernière semaine des campagnes provinciales de 2012 et 2013 qui ont eu lieu en Alberta et en Colombie-Britannique où des victoires écrasantes ont été prédites à tort pour les partis d'opposition. Dans ce contexte où les sondeurs multiplient les résultats décevants, les modèles prédictifs apparaissent de plus en plus comme une solution de rechange ou, à tout le moins, comme un nouveau point de comparaison pouvant servir à mettre en perspective les résultats de sondages. Après avoir établi notre modèle structurel, nous évaluons le potentiel d'une analyse de régressions apparemment indépendantes pour prédire le pourcentage du vote populaire récolté par le parti sortant ainsi que le score de ses compétiteurs.
Avant d'aborder les principaux modèles existants pour les régimes parlementaires, mentionnons qu'il existe différents tests et indicateurs pour juger de la précision et des capacités prédictives d'un modèle. La prévision intra-échantillon (within-sample forecast) constitue le test le plus simple et le moins exigeant puisque l'ensemble des données disponibles sont exploitées afin de réaliser les prédictions. La prévision hors-échantillon (out-of-sample forecast) consiste pour sa part à retirer de l’équation les données associées au scrutin dont nous souhaitons estimer le résultat, ce qui constitue déjà un test beaucoup plus strict (Lewis-Beck, Reference Lewis-Beck2005: 153). Parmi les indicateurs qu'on peut tirer de ces tests, l'erreur moyenne absolue ou mean absolute error (MAE) est l'un des plus fréquemment rapportés. L'erreur moyenne absolue représente l’écart entre les scores prédits et réels, la valeur absolue indiquant que l'on pénalise de manière égale les erreurs positives et négatives (voir Fair, Reference Fair1984: 261–62; Mathis et Brociner, Reference Mathis and Brociner1994: 215).
2. La prévision électorale aux États-Unis et dans les systèmes parlementaires
2.1 Quelques caractéristiques des modèles américains
La littérature sur la prévision électorale aux États-Unis tourne principalement autour de deux facteurs, à savoir l’évolution de l’économie et la popularité du président sortant (Lewis-Beck, Reference Lewis-Beck2005: 150). Les mesures économiques retenues peuvent certes varier, mais celles-ci partagent généralement quatre caractéristiques : (1) il s'agit d'indicateurs objectifs et non d’évaluations subjectives de la part des électeurs; (2) ces mesures sont basées sur la théorie rétrospective plutôt que prospective du vote économique; (3) elles concernent l’état de l’économie nationale plutôt que les finances personnelles des citoyens; et (4) celles-ci sont plus souvent relatives que « statiques » (autrement dit, on observe la croissance ou la décroissance par rapport à une période antérieure).
Outre l’économie et la popularité, quelques auteurs intègrent également des mesures de longévité gouvernementale et d’incumbency (par exemple, Abramowitz, Reference Abramowitz2016; Lockerbie, Reference Lockerbie2016) afin de tenir compte de l'usure du pouvoir et des bénéfices qui accompagnent la présence d'un président éligible à un second mandat. On remarquera par ailleurs que le décalage typique des modèles américains se situe dans la plupart des cas entre trois et six mois. Selon Nadeau et coll. (Reference Nadeau, Lewis-Beck and Bélanger2009: 336), le décalage le plus commun serait maintenant de deux ou trois mois avant l’élection. En outre, la variable dépendante des modèles américains correspond, dans la vaste majorité des cas, à la part du vote bipartite ou two-party vote share récolté par le parti présidentiel ou son candidatFootnote 3.
2.2 Les modèles britanniques et allemands
Le Royaume-Uni et l'Allemagne sont les régimes parlementaires pour lesquels on retrouve le plus de modèles prédictifsFootnote 4. Ces modèles partagent plusieurs traits avec les équations américaines. D'abord, l’économie et l'approbation du gouvernement (ou de son chef) y occupent une place centrale. Ensuite, les prévisionnistes qui se sont penchés sur les élections britanniques et allemandes ont généralement exploité les notions d'usure du pouvoir et de cycle électoral (à ce sujet, voir Norpoth, Reference Norpoth2004; Reference Norpoth2014), qui expriment l’érosion graduelle des appuis du gouvernement en place au fil du temps. Les modèles européens se démarquent toutefois à certains égards des équations américaines. Aux États-Unis, l'usage du vote bipartite comme variable dépendante permet de déterminer le résultat des deux grands partis à l'aide d'un seul et même modèle. En effet, une fois qu'est connu le score d'un parti, on connaît automatiquement le score de l'autre. Bien qu'adaptée à la réalité politique américaine, une telle variable n'est toutefois pas adéquate pour les systèmes multipartites comme le Royaume-Uni ou l'Allemagne. Par conséquent, dans ces régimes, d'autres avenues demandent à être explorées.
En ce qui a trait aux scrutins britanniques, plutôt que d'employer la part du vote populaire recueilli par la formation sortante, Lebo et Norpoth (Reference Lebo and Norpoth2007; Reference Lebo and Norpoth2011; Reference Lebo and Norpoth2013; Reference Lebo and Norpoth2016) se sont servis de la différence entre le pourcentage des voix récoltées par le Parti conservateur et le pourcentage des voix récoltées par le Parti travailliste (Conservative lead). Pour leur part, Nadeau et coll. (Reference Nadeau, Lewis-Beck and Bélanger2009) ont adopté une approche novatrice (qui, à notre connaissance, n'a pas encore été appliquée aux États-Unis) en élaborant un modèle en deux étapes (two-step model), c'est-à-dire en utilisant d'abord une mesure indirecte (un proxy) du vote en faveur du parti sortant – soit un indice d'approbation globale du gouvernement et du premier ministre – dans une équation prédictive (étape 1) puis en faisant ensuite de ce même proxy la variable dépendante d'une équation explicative comprenant des facteurs politiques et économiques (étape 2)Footnote 5. Nadeau et coll. ne se sont toutefois pas arrêtés à la prévision des résultats du parti sortant. Ceux-ci ont également proposé deux autres modèles afin de prédire (1) l’écart entre le pourcentage des voix du parti ministériel et le pourcentage des voix du principal parti d'opposition (government lead) et (2) le score de l'opposition officielle.
Dans le cas des élections au Bundestag allemand, Norpoth et Gschwend (Reference Norpoth and Gschwend2003; Reference Norpoth and Gschwend2010; Reference Norpoth and Gschwend2013; Reference Norpoth and Gschwend2017a; Reference Norpoth and Gschwend2017b) utilisent (sauf exception) le vote combiné des partis de la coalition sortante. Kayser et Leininger (Reference Kayser and Leininger2016) ont également proposé un modèle qui estimait, tout comme l’équation de Norpoth et Gschwend, la part des voix obtenues par les partis intégrés à la coalition gouvernementale, mais ont par la suite suggéré l'usage d'un modèle désagrégé au niveau des Länder (Kayser et Leininger, Reference Kayser and Leininger2017). Cette approche, qui a l'avantage d'accroître considérablement le nombre d'observations disponibles, a notamment été employée pour prédire les résultats d’élections aux États-Unis (voir, par exemple, Jérôme et Jérôme-Speziari, Reference Jérôme and Jérôme-Speziari2016; Rosenstone, Reference Rosenstone1983) et en France (voir, par exemple, Foucault et Nadeau, Reference Foucault and Nadeau2012; Jérôme et Jérôme-Speziari, Reference Jérôme and Jérôme-Speziari2012). Essentiellement, Kayser et Leininger ont utilisé, aux côtés d'autres variables, les résultats lors des élections régionales et nationales dans les Länder afin d'estimer les scores fédéraux de tous les partis à l’échelle du Land et de l'Allemagne entière. Enfin, dans un autre modèle, Jérôme et coll. (Reference Jérôme, Jérôme-Speziari and Lewis-Beck2013; Reference Jérôme, Jérôme-Speziari and Lewis-Beck2017) offrent un ensemble de régressions apparemment indépendantes pour les partis allemandsFootnote 6. Jérôme et coll. proposent donc un ensemble de six équations, à savoir pour le parti du chancelier (en l'occurrence, le CDU ou le SPD), le principal parti d'opposition, le FDP, Les Verts, Die Linke/PDS et les autres formations. Les équations pour les plus petits partis étaient essentiellement basées sur leur potentiel électoral tel que mesuré par les intentions de vote en leur faveur. Une fois les prédictions réalisées pour chaque parti, les auteurs appliquaient un ratio de conversion (swing ratio) afin de transformer les voix en sièges.
De manière générale, les modèles britanniques et allemands témoignent de la nécessité de repenser la définition de la variable dépendante ou la méthode de prédiction employée dans le cas des systèmes multipartites où la construction d'une équation unique vouée à prédire le pourcentage des voix du parti sortant ne constitue pas nécessairement l'option la plus appropriée.
2.3 Les modèles canadiens
Bien que la création de fonctions de vote et de popularité ne soit pas chose nouvelle au Canada (voir, par exemple, Carmichael, Reference Carmichael1990; Happy, Reference Happy1986; Reference Happy1989; Reference Happy1992; Monroe et Erickson, Reference Monroe and Erickson1986), peu de modèles prévisionnels ont été développés pour les élections canadiennes. À notre connaissance, Nadeau et Blais (Reference Nadeau and Blais1993) sont les premiers politologues à avoir élaboré, au début des années 1990, un modèle prédictif pour le Canada. Plus précisément, ces deux auteurs cherchent à expliquer et à prédire la performance du Parti libéral au moyen des scrutins fédéraux qui ont eu lieu depuis 1953.
Ce modèle ne comprend que deux variables, à savoir un facteur économique ainsi qu'un facteur politique. Le facteur économique repose sur l'idée du vote rétrospectif voulant que les électeurs récompensent le gouvernement en période de croissance et s'en détournent lorsque l’économie nationale connaît des moments difficiles. Par ailleurs, selon Nadeau et Blais (Reference Nadeau and Blais1993: 778), pour qu'un électeur puisse juger de manière convenable la performance de ses dirigeants, il faut que le gouvernement reste en place sur une période suffisamment longue, sans quoi l'attribution de responsabilité n'a pas vraiment de sens. Pour les deux auteurs, cette condition n'a pas été respectée lors des scrutins de 1958 et 1980 lorsque les Progressistes-Conservateurs de John Diefenbaker puis de Joe Clark se sont retrouvés face à l’électorat après seulement quelques mois de gouverne. Trois variables économiques sont testées, à savoir le revenu disponible réel, l'inflation et le chômage. Ces trois indicateurs sont construits en termes relatifs, en ce sens que c'est le changement dans la situation de l’économie par rapport à un état antérieur qui est jugé pertinent et non la situation immédiate telle qu'elle se présente avant la tenue du vote. Concrètement, la mesure élaborée par les auteurs correspond à la moyenne de la différence, sur les 10 trimestres précédant l’élection, entre le taux de chômage (ou d'inflation ou de croissance du revenu) dans un trimestre donné et le taux moyen dans les cinq années précédentes. On remarquera que cette opérationnalisation des indicateurs économiques assume que l’électeur a la mémoire relativement longue puisque la performance du gouvernement se trouve à être jugée sur une période de deux ans et demi. La variable non économique de Nadeau et Blais concerne, quant à elle, l'origine provinciale des leadersFootnote 7. Il semble en effet que la présence d'un chef québécois sur la scène politique fédérale constitue un avantage majeur pour un parti, ne serait-ce qu'en raison de l'attrait que cela exerce chez les électeurs du Québec, qui seraient en quelque sorte motivés à soutenir « l'un des leurs » (Nadeau et Blais, Reference Nadeau and Blais1993: 779–80).
Au final, deux modèles de régression étaient retenus par les auteurs, l'un exploitant l'ensemble des élections qui ont eu lieu entre 1953 et 1988, l'autre faisant fi des scrutins de 1958 et 1980 pour la raison que nous avons évoquée plus haut. On notera que des trois variables économiques testées par Nadeau et Blais, seule l’évolution du taux de chômage était statistiquement significative. Que la régression soit estimée avec la totalité des observations ou en excluant les scrutins de 1958 et 1980, une hausse d'un point de pourcentage dans le taux de chômage relatif entraîne, toutes choses étant égales par ailleurs, une diminution d’à peu près deux points dans le vote en faveur du Parti libéral. En outre, la présence d'un chef québécois semble effectivement constituer un atout considérable : lorsque les Libéraux ont un Québécois à leur tête et qu'aucune autre formation politique n'est dirigée par un individu originaire de cette province, ceux-ci peuvent s'attendre à un gain substantiel d'environ six points de pourcentage. On remarquera toutefois que la part de la variance expliquée dans le vote libéral est plus élevée (0,83 par rapport à 0,71) et l'erreur standard d'estimation plus basse (2,48 par rapport à 3,18) lorsque les courses de 1958 et 1980 sont exclues du calcul (Nadeau et Blais, Reference Nadeau and Blais1993: 781–84)Footnote 8. Qu'en est-il maintenant sur le plan de la précision? Le modèle de Nadeau et Blais faisant abstraction des courses de 1958 et 1980 présente une MAE hors-échantillon de 2,30 points de pourcentage contre 2,77 points pour le modèle qui couvre la totalité des élections. En somme, les modèles proposés permettent d'obtenir des estimations assez précises, et ce, avec un faible nombre de variables.
Le premier modèle politico-économique voué à la prédiction des résultats du parti sortant lors des élections fédérales canadiennes est de conception assez récente. On doit ce modèle à Bélanger et Godbout (Reference Bélanger and Godbout2010). Le modèle de ces deux auteurs, initialement publié sous la forme d'articles de presse dans Le Devoir puis le Toronto Star pour les élections de 2000, 2004 et 2006, utilise trois variables campées dans la théorie du vote rétrospectif et la notion de volonté de changement (time-for-change). Parmi toute la gamme possible des mesures économiques, Bélanger et Godbout ont retenu le taux de chômage national pour le deuxième trimestre précédant l’élection. Si on en croit les auteurs, « all the most recent aggregate-level studies of economic voting in Canadian federal elections have shown [unemployment] to be the single most effective economic predictor of the vote in the country, outperforming any other macroeconomic variable » (Bélanger et Godbout, Reference Bélanger and Godbout2010: 692). Par ailleurs, l'absence de mesures de chômage mensuelles avant le début des années 1950 force Bélanger et Godbout à prendre le scrutin de 1953 comme point de départ de leur modèle.
Cette variable économique est combinée à deux variables de nature politique, à savoir le taux de satisfaction envers le gouvernement en place ainsi que le logarithme naturel du nombre de mois passés au pouvoir par le parti sortant au moment de l’élection. Le taux de satisfaction n’étant disponible que pour une poignée de scrutins, les auteurs se rabattent sur une mesure approximative, soit les intentions de vote en faveur de la formation ministérielle trois mois avant l’élection. Pour sa part, le facteur de longévité exprime simplement la tendance qu'a l’électorat à vouloir remplacer ses gouvernants après plusieurs années d'une même administration. Autrement dit, l'exercice du pouvoir aurait un coût que le gouvernement doit éventuellement payer (Bélanger et Godbout, Reference Bélanger and Godbout2010: 693).
La combinaison de ces trois facteurs explique environ 65 pour cent de la variance dans le vote en faveur du gouvernement sortant, ce qui est relativement modeste par rapport à plusieurs des modèles élaborés pour d'autres pays. En moyenne, l’écart absolu entre les prévisions hors-échantillon et les scores réels est légèrement inférieur à 4,3 points de pourcentageFootnote 9. Alors que dans certains cas le modèle performe particulièrement bien, dans d'autres, la différence entre les prévisions et les résultats est substantielle. Par exemple, pour cinq des prévisions hors-échantillon (soit 1958, 1965, 1979, 1988 et 1993), l'erreur moyenne absolue dépasse les huit points de pourcentage. Comme l'indiquent Bélanger et Godbout (Reference Bélanger and Godbout2010: 694), il se peut que la campagne, les enjeux de l'heure et un certain nombre d’éléments idiosyncratiques aient rendu le modèle moins pertinent pour ces scrutins. Selon les auteurs, le débat sur le libre-échange en 1988 et la piètre performance de Kim Campbell et son équipe en 1993 pourraient expliquer les ratés du modèle pour ces deux élections.
3. Un nouveau modèle pour les élections fédérales canadiennes
Les modèles que nous venons d'examiner possèdent sans contredit plusieurs mérites. Tout d'abord, ceux-ci permettent d’établir l'importance du chômage comme principal indicateur économique de référence chez les Canadiens et les Canadiennes en période électorale. En outre, l'introduction par Nadeau et Blais d'une variable d'origine provinciale accordant une place particulière au Québec met à la disposition des prévisionnistes un indicateur résolument canadien qui permet d'aller au-delà du simple modèle d’économie-popularité typique généralement appliqué à l'ensemble des États. Par ailleurs, le propos de Nadeau et Blais sur le problème de la trop grande proximité de certains scrutins est également pertinent : lorsqu'une élection a lieu peu de temps après l'arrivée d'un nouveau parti au gouvernement, il est peut-être plus judicieux de l'exclure du modèle.
Certains éléments demandent néanmoins à être revus. Alors que le modèle proposé par Nadeau et Blais concerne le Parti libéral et non le parti sortant, l’équation créée par Bélanger et Godbout explique une part trop congrue de la variance dans le vote récolté par la formation gouvernementale et produit des estimations souvent éloignées des scores réels. Par ailleurs, la mesure de popularité retenue par Bélanger et Godbout nous semble inadéquate : on ne peut pas considérer les intentions de vote comme une mesure équivalente au taux d'approbation du gouvernement en poste. Cette mesure rend en outre la précision du modèle en partie dépendante de la qualité des sondages et n'amène rien de bien concret sur le plan explicatif. Et, bien que le commentaire de Nadeau et Blais sur la proximité des courses électorales soit digne de réflexion, nous verrons plus loin que le retrait des scrutins de 1958 et 1980 ne nous semble pas réellement justifié. Enfin, les modèles existants ne permettent d'estimer le score que d'un seul parti et donnent donc nécessairement une image très partielle des résultats électoraux dans un système multipartite comme le Canada. En travaillant à partir des variables identifiées par Nadeau et Blais puis Bélanger et Godbout, nous proposons un nouveau modèle afin d'estimer avec quelques mois d'avance la part des voix amassées par le parti sortant lors des élections fédérales canadiennes ainsi que différents modèles SUR.
3.1 Les variablesFootnote 10
Nous avons déterminé plus haut que le chômage constituait probablement l'indicateur économique le plus pertinent pour les électeurs canadiens. Au Canada, la collecte périodique de données de chômage n'a débuté qu'en novembre 1945 avec la conduite de l'Enquête sur la population active (EPA) par le Bureau fédéral de la statistique. Comme l'EPA a été conduite trimestriellement (plutôt que mensuellement) de 1946 à 1952 (Gower, Reference Gower1992), nous ne pouvons inclure l’élection de 1949 dans notre modèle. Par conséquent, le modèle que nous allons élaborer reposera sur les scrutins qui ont eu lieu de 1953 à 2015, ce qui donne 21 observations.
Se pose maintenant la question de savoir comment mesurer le taux de chômage ou, le cas échéant, l’évolution du taux de chômage. Alors que Nadeau et Blais (Reference Nadeau and Blais1993; Reference Nadeau and Blais1995) proposent l'emploi d'une mesure relative de cet indicateur économique et que Bélanger et Godbout (Reference Bélanger and Godbout2010) optent pour une mesure fixe, nous proposons pour notre part l'utilisation d'une mesure comparative du taux de chômage. Il se peut en effet que les Canadiens aient un œil sur leur voisin du Sud et principal partenaire commercial lorsqu'arrive le moment de juger l’état de l’économie nationale – une idée déjà avancée par Carmichael (Reference Carmichael1990: 719). Si l’économie va mieux aux États-Unis qu'au Canada, les électeurs canadiens pourraient bien être tentés de punir le gouvernement en place. Comme le mentionnent Kayser et Peress, « [v]oters in a wide variety of democracies benchmark national economic growth against that abroad, punishing (rewarding) incumbents for national outcomes that underperform (outperform) an international comparison » (Reference Kayser and Peress2012: 661; mais voir Arel-Bundock et coll., Reference Arel-Bundock, Blais and Dassonnevilleà paraître). Kayser et Leininger (Reference Kayser and Leininger2016) ont d'ailleurs employé avec succès une variable économique comparative dans un modèle prédictif dédié aux élections fédérales allemandes, à savoir la performance relative de l'Allemagne par rapport aux trois autres plus grandes économies européennes – la France, le Royaume-Uni et l'Italie – en termes de croissance du produit intérieur brut. Jérôme et coll. (Reference Jérôme, Jérôme-Speziari, Lewis-Beck, Reynié and Cautrès2001: 110) ont également constaté que les électeurs français et allemands étaient sensibles à l’écart existant entre leurs deux pays sur le plan de la croissance économique.
Puisque l’élection fédérale de 1953 s'est déroulée en août, nous pouvons reculer jusqu’à sept mois avant la tenue du vote pour chacune des années qui composent notre échantillon de cas (avant cela, les données n'ont pas été colligées mensuellement). On peut donc se demander pour l'ensemble des élections de notre modèle si le taux de chômage canadien (lorsque comparé au taux américain) a plus d'impact un mois, deux mois, trois mois, quatre mois, cinq mois, six mois ou sept mois avant le vote. Un décalage trop important est toutefois inapproprié pour les élections qui ont suivi des gouvernements de courte durée comme 1958 ou 1980 (qui n'ont même pas franchi le cap des 300 jours). Par exemple, il faut bien réaliser que prendre le taux de chômage lors du septième mois précédant l’élection de 1958, correspond en réalité à observer la situation de l'emploi environ deux mois après le scrutin de 1957. Il est impensable que les électeurs aient pu faire le bilan du premier gouvernement Diefenbaker en aussi peu de temps. Pour surmonter cette complication, nous avons décidé de nous rabattre sur un décalage plus court de trois mois. Certes, il est également possible, comme le font Nadeau et Blais (Reference Nadeau and Blais1993), de retirer les élections problématiques du modèle. Toutefois, nous ne croyons pas que cette option soit réellement justifiable. Afin de déterminer le potentiel de nuisance des élections de 1958 et 1980, nous avons calculé la distance de Cook pour ces observations. La distance de Cook sert à estimer l'influence de chaque observation sur la régression et permet ainsi d'identifier les cas aberrants. Il s'agit d'une mesure de distance standardisée permettant de décrire le changement dans la valeur des coefficients lorsqu'une observation est incluse dans le modèle et lorsque celle-ci en est retirée. Une valeur de Cook élevée pour une observation suggère que celle-ci a une influence importante sur la régression et qu'elle biaise possiblement l'estimation des coefficients. Différentes règles existent pour déterminer si une observation devrait être retirée de l'analyse, mais on considère généralement une observation comme potentiellement problématique si la distance de Cook qui lui est associée est supérieure à 1 (Weisberg, Reference Weisberg2005: 198–200). Notons qu'il est aussi possible de calculer la distance de Cook lorsque plusieurs observations sont simultanément retranchées de la régression. La distance de Cook pour les élections de 1958 et 1980 est à peu près égale à 0,20 (en ce qui a trait au modèle proposé, Eq. 1), soit nettement en deçà de 1 (la distance de Cook pour ces deux scrutins est également inférieure à 1 pour le modèle de Nadeau et Blais). Nous préférons par conséquent conserver ces scrutins pour l'estimation du modèle.
L’économie n'explique pas tout bien sûr. Outre le chômage, quatre indicateurs politiques sont envisagés, à savoir l'origine provinciale du premier ministre en placeFootnote 11, la longévité du gouvernement, la venue d'un nouveau chef peu de temps avant l'organisation d'un scrutin et l'expérience politique relative du premier ministre. À supposer que l'actuel gouvernement de Justin Trudeau reste en place jusqu'en octobre 2019, un Québécois aura été à la tête du pouvoir exécutif pendant 47 des 74 années qui ont suivi la fin de la Seconde Guerre mondiale. Sur les 22 courses qui ont eu lieu après 1945, 12 ont mené à l’élection d'un gouvernement dirigé par un candidat originaire du Québec. La présence d'un chef québécois au sein du parti ministériel pourrait donc constituer un atout important. Nous empruntons la première de nos variables non économiques à Nadeau et Blais (Reference Nadeau and Blais1993: 780–81) telle que révisée par Bélanger et Godbout (Reference Bélanger and Godbout2010: 696). Celle-ci prend par conséquent une valeur de :
• +1 lorsque le chef du parti sortant est originaire du Québec et que cela n'est le cas d'aucun autre leader;
• +0,5 lorsque le chef du parti sortant est originaire du Québec et que cela est également le cas d'un chef de parti mineur (Crédit social, Ralliement des créditistes, Bloc québécois) ou encore d'un chef de parti mineur et d'un chef de parti majeur (Parti conservateur, Parti libéral, CCF-NPD);
• 0 lorsqu'aucun des chefs n'est originaire du Québec;
• −0,5 lorsque le chef du parti sortant n'est pas originaire du Québec, mais que cela est le cas d'un chef de parti mineur ou encore d'un chef de parti mineur et d'un chef de parti majeur; et
• −1 lorsque le chef du parti sortant n'est pas originaire du Québec, mais que cela est le cas d'un chef de parti majeur (en l'absence d'un chef québécois au sein d'un parti mineur).
La seconde variable, tirée cette fois-ci du modèle de Bélanger et Godbout (Reference Bélanger and Godbout2010: 693), correspond au logarithme naturel du nombre de mois passés au pouvoir avant que le parti ministériel ne soit renvoyé sur les bancs de l'oppositionFootnote 12. La notion d’« usure du pouvoir » a été exploitée dans de nombreux modèles (par exemple, Abramowitz, Reference Abramowitz2016; Nadeau et coll., Reference Nadeau, Lewis-Beck and Bélanger2009). L'idée qui se cache derrière cette expression est relativement simple : après plusieurs années au pouvoir d'un même parti ou d'un même chef, il est probable que l’électorat manifeste une volonté de changement (Shiraev et Sobel, Reference Shiraev and Sobel2016: 242). À cette variable, nous en joignons une autre qui capture l'effet potentiel que pourrait exercer la venue d'un nouveau leader à la tête du parti sortant quelques semaines ou mois avant une élection. Une nouvelle figure politique à la tête du gouvernement pourrait aider à combattre l'usure du pouvoir (ou encore à amoindrir l'effet d'un bilan économique négatif). Concrètement, il s'agit d'une variable dichotomique codée 1 lorsque le chef du gouvernement cède ses fonctions à un nouvel individu à proximité d'une course électorale et 0 autrement. En 1968, 1984, 1993 et 2003, à quelques mois des élections fédérales, le premier ministre en poste a quitté ses fonctions, laissant ainsi à quelqu'un d'autre le soin de diriger le gouvernement.
Enfin, nous proposons l'usage d'une variable exprimant l'expérience politique du chef du gouvernement. À notre connaissance, l'expérience politique objective d'un candidat n'a été testée comme variable prédictive que par Lewis-Beck et Rice (Reference Lewis-Beck and Rice1984a: 14–15) pour les élections présidentielles américaines. Pourtant, ce facteur n'est pas sans intérêt : la compétence constituerait l'une des caractéristiques les plus importantes parmi celles prises en compte par les citoyens dans leur appréciation des candidats (voir, par exemple, Bean, Reference Bean1993; Bittner, Reference Bittner, Anderson and Stephenson2010). Après tout, les gens ne font pas qu’élire des « porteurs d'idées », ils confient également les rênes du pouvoir à des individus qui seront appelés à remplir le rôle de « gestionnaires » capables de manœuvrer l'appareil gouvernemental, d'en exploiter tous les ressorts et de régler les problèmes du moment et ceux qui pourraient se présenter dans l'avenir (Popkin, Reference Popkin1991: 61). Plutôt que d'opter pour une mesure subjective de compétence, nous avons choisi une variable retraçant l'expérience politique objective des candidats. Trois raisons justifient ce choix. D'abord, d'un point de vue tout à fait pratique, nous ne disposons pas de mesures subjectives de compétence disponibles avant les élections et pour une période suffisamment longue. Comme l'indiquent avec humour Norpoth et Gschwend, « [m]easuring […] variables over a span of 50 years or so, like making sausages, is not something for purists. Opinion surveys track few if any questions over such long periods » (Reference Norpoth and Gschwend2010: 44). Ensuite, comme nous l'avons déjà mentionné, l'utilisation de données de sondages est contraire à l'objectif de notre recherche. Enfin, nous sommes intéressés à savoir ce que vaut concrètement, lors d'une élection, le « CV politique » d'un candidat : en d'autres mots, l'individu qui dispose de longues années de service auprès de l’État a-t-il un avantage net sur ses rivaux moins expérimentés? Il faut dire en outre qu'une variable relative à l'expérience des candidats n'exprime probablement pas seulement la compétence de ceux-ci, mais risque également de refléter leur notoriété au sein de la population.
Notre variable d'expérience correspond à la différence entre le nombre d'années passées en politique provinciale et fédérale en tant qu’élu ou haut fonctionnaire par le premier ministre sortant et le nombre d'années cumulées dans la même sphère par son principal concurrentFootnote 13. Plus précisément, la mesure retenue concerne l'exercice des fonctions suivantes : député, sous-ministre, ambassadeur, sénateur, chef de parti, chef de l'opposition officielle, ministre et premier ministre. L'identité du principal concurrent du premier ministre porte à réflexion : l'option la plus évidente consiste à faire du chef du parti ayant obtenu le second plus grand pourcentage de voix à l’élection précédenteFootnote 14 le plus grand rival du premier ministre. Mais on peut aussi penser que les Canadiens réfléchissent surtout en termes de confrontation entre Libéraux et (Progressistes-)Conservateurs, qui sont, après tout, les seuls à avoir formé le gouvernement depuis 1867. En d'autres mots, lorsque le premier ministre est libéral, la figure de comparaison serait le chef (progressiste-)conservateur et vice versa. Cette option nous semble la plus raisonnable. On notera de toute manière qu'il n'est arrivé qu’à trois reprises que le chef du parti ayant obtenu le second plus grand pourcentage de voix à l’élection précédente ne soit pas issu de l'une de ces deux formations politiques au déclenchement d'une campagne électorale (soit Preston Manning en 1997, Stockwell Day en 2000 et Thomas Mulcair en 2015, qui se trouvent donc à être remplacés respectivement par Jean Charest, Joe Clark et Justin Trudeau).
3.2 Les résultats
Notre modèle comporte donc un total de cinq variables, soit un facteur économique reposant sur la notion de vote rétrospectif et quatre facteurs de nature politique. La combinaison de ces variables produit le modèle suivant (équation 1)Footnote 15:
 $$V = {\rm} {59,}{83}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\rm} \ndash {\rm} {3,}{52}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}C\,\ndash\,{\rm} {4,}{28}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}M + {\rm} {6,}{44}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}L \!+\! {\rm} {12,}{81}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}Q + {\rm} {0,}{32}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}E + \,{\rm \varepsilon} $$
 $$R^2 = {0,}{89};R^2 {\hyphen} {\rm ajust} {{\rm e}\hskip-1.5pt\acute}} = {0,}{86};\hbox{SEE} = {3,}{00};$$
 $$\hbox{DW} = {2,}{72};\hbox{N} = 21{\; } \lpar {1953\!-\!2015} \rpar $$
***p < 0,01
**p < 0,05
*p < 0,10
V = le pourcentage des votes obtenus par le parti sortant;
C = la différence entre le taux de chômage canadien et le taux de chômage américain trois mois avant l’élection (benchmark);
M = le logarithme naturel du nombre de mois passés au pouvoir par le parti sortant;
L = une variable dichotomique codée 1 lorsque le chef du gouvernement cède ses fonctions à un nouveau leader à proximité d'une course électorale et 0 autrement;
Q = l'origine provinciale du premier ministre sortant par rapport aux autres chefs de partis codée −1, −0.5, 0, +0.5 ou +1 selon la situation;
E = la différence entre le nombre d'années passées en politique provinciale et fédérale en tant qu’élu ou haut fonctionnaire par le premier ministre sortant et le nombre d'années cumulées dans la même sphère par son concurrent libéral ou conservateur selon l'affiliation partisane du premier ministre; et
ε = un terme d'erreur.
Le modèle explique environ 86 pour cent de la variance dans le vote, une amélioration par rapport au modèle proposé par Bélanger et Godbout (Reference Bélanger and Godbout2010) dont la valeur du R 2-ajusté atteint 0,65. L'impact du benchmark est net : toutes choses étant égales par ailleurs, lorsque le pourcentage de chômeurs canadiens croît d'un point par rapport au pourcentage qui existe de l'autre côté de la frontière, le parti sortant peut s'attendre à perdre environ 3,5 points de pourcentage. Le temps passé au pouvoir possède lui aussi un effet notable sur le score de la formation ministérielle : une augmentation d'un point dans le logarithme du nombre de mois au gouvernement réduit de plus de quatre points le pourcentage des voix du parti sortant. Le départ du premier ministre et sa substitution par un nouveau chef quelques semaines ou mois avant une élection semble également avoir un impact considérable sur les scores du parti sortant : une telle alternance au pouvoir s'accompagnerait d'un gain dépassant les six points. L'origine provinciale dispose pour sa part d'un impact substantiel : lorsque le premier ministre en poste est originaire du Québec et que cela n'est le cas d'aucun autre chef, le parti au pouvoir peut s'attendre à aller chercher près de 13 points de pourcentage supplémentaires. À première vue, l'effet de l'expérience relative des chefs peut sembler plutôt modeste. Une année de plus en politique pour le chef du parti sortant par rapport à son principal adversaire ne se traduit que par une hausse d'un tiers de point dans le vote populaire. Il faut cependant souligner que d'importants écarts en termes d'expérience séparent généralement le premier ministre de son principal concurrent traditionnel. La différence moyenne et la différence médiane (en termes absolus) se chiffrent à environ 10 ans. Une décennie de plus au service de l’État permettrait un gain électoral avoisinant les trois points de pourcentage.
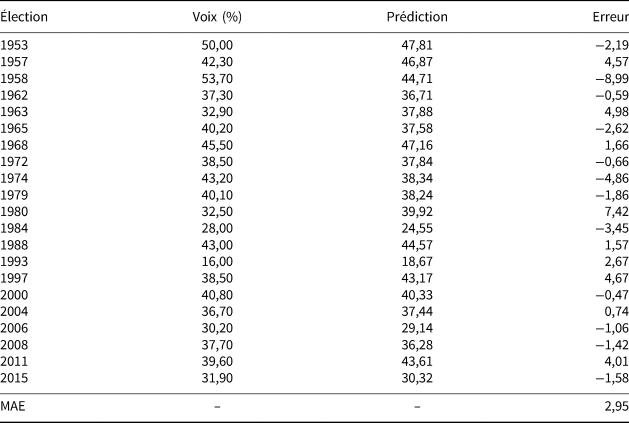
Le tableau 1 présente les prévisions hors-échantillon du modèle pour les élections fédérales de 1953 à 2015. L'erreur moyenne absolue (hors-échantillon) est de 2,95 points de pourcentage. L'erreur dépasse les trois points pour huit des 21 élections et les cinq points pour deux scrutins seulement (ceux de 1958 et 1980). On notera aussi que le modèle n'a qu'un peu plus tendance à sous-estimer le score du parti sortant (12 cas) qu’à le surestimer (neuf cas).
Prédictions hors-échantillon du modèle, 1953–2015

Jusqu’à présent, nous avons parlé du pourcentage des voix obtenues par le parti sortant. Bien qu'utile, cette information n'est toutefois pas suffisante pour savoir si le parti au pouvoir sera à nouveau en mesure de former le gouvernement à l'issue d'une élection. Ultimement, c'est la distribution des sièges entre les partis qui devrait retenir notre attention. Nous pouvons établir un ratio de conversion afin d'estimer le pourcentage des sièges du parti sortant à partir de son pourcentage des voix. Il suffit de régresser le premier sur le second (voir Bélanger et Godbout, Reference Bélanger and Godbout2010: 695), ce qui donne l’équation 2 :
 $$S = {\rm} -\!{31,}{90}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\rm} + {\rm} {2,}{00}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}{\raise1pt{\hbox {*}}}V + {\rm \mu} $$
 $$R^2 = {\rm} {0,}{90};R^2 {\hyphen} {\rm ajust}{\acute{\rm e}} = {\rm} {0,}{89};\hbox{SEE} = {\rm} {5,}{53};$$
 $$\hbox{DW} = {\rm} {1,}{84};\hbox{N} = {\rm} 21{\;} \lpar {1953\!-\!2015} \rpar $$
***p < 0,01
**p < 0,05
*p < 0,10
S = le pourcentage des sièges obtenus par le parti sortant;
V = le pourcentage des votes obtenus par le parti sortant; et
μ = un terme d'erreur.
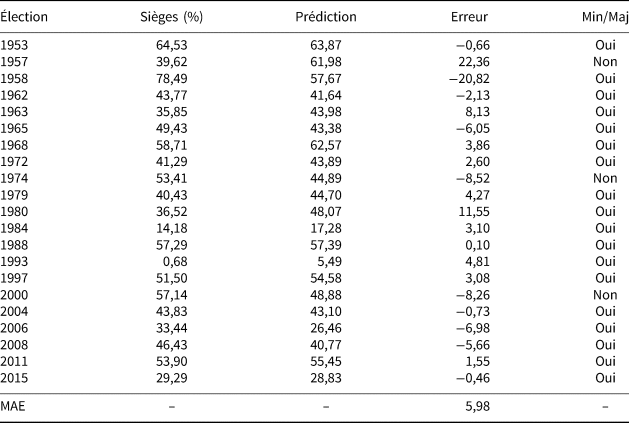
S'il n'existe pas de rapport parfaitement proportionnel entre voix et sièges sous le système uninominal pluralitaire à un tour, l'association entre les deux reste néanmoins très forte comme le montre le coefficient de détermination multiple ajusté de 0,89. Pour un point de pourcentage de plus dans les suffrages du parti sortant, ce dernier peut s'attendre à aller chercher deux points supplémentaires dans son pourcentage des sièges à la Chambre des communes. Il est important de souligner qu'il n'est guère possible de savoir avec certitude si le parti sortant formera le prochain gouvernement lorsque celui-ci obtient moins de la majorité des sièges à la Chambre des communes (Cyr, Reference Cyr2013: 389). Nous pouvons néanmoins évaluer si notre modèle est capable de prédire correctement l'obtention par le parti sortant d'une minorité ou d'une majorité de sièges – ce qui constitue tout de même un renseignement important. Comme le montre le tableau 2, lorsque les prévisions hors-échantillon de notre modèle sont utilisées dans l’équation du ratio de conversion, celui-ci ne fait fausse route qu’à trois reprises (soit en 1957, 1974 et 2000). Autrement dit, dans la vaste majorité des cas, le ratio de conversion couplé aux estimations du modèle permet de savoir si le parti sortant formera un gouvernement majoritaire ou s'il obtiendra une minorité de sièges – auquel cas, il peut soit former un gouvernement minoritaire ou se retrouver dans l'opposition. Plus de détails concernant le ratio de conversion ont été placés en annexe (section E).
Prédictions du modèle de conversion des votes en sièges, 1953–2015

Note : La colonne Min/Maj indique si le ratio de conversion a, oui ou non, correctement prédit l'obtention d'une minorité ou d'une majorité de sièges à la Chambre des communes par le parti sortant.
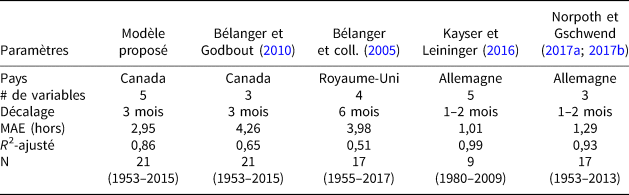
Enfin, le tableau 3 offre une comparaison de notre modèle avec les modèles comparables qui existent pour le Canada, le Royaume-Uni et l'AllemagneFootnote 16. Comme nous l'avons déjà mentionné, par rapport au modèle offert par Bélanger et Godbout (Reference Bélanger and Godbout2010), notre propre modèle se révèle beaucoup plus performant. Il est vrai toutefois que l’équation prévisionnelle de Bélanger et Godbout est plus parcimonieuse dans la mesure où celle-ci n'intègre que trois variables. Néanmoins, en termes de réduction de l'erreur, d'explication de la variance et de sophistication théorique, nous croyons que notre modèle constitue un outil prédictif et explicatif nettement plus efficace. Le modèle que nous proposons est également plus précis que l’équation structurelle la plus récente de Bélanger et coll. (Reference Bélanger, Lewis-Beck and Nadeau2005) pour le Royaume-Uni, qui n'explique d'ailleurs que 51 pour cent de la variance dans le vote populaire en faveur du parti sortant. Les modèles allemands de Kayser et Leininger (Reference Kayser and Leininger2016) et de Norpoth et Gschwend (Reference Norpoth and Gschwend2017a; Reference Norpoth and Gschwend2017b) se révèlent, quant à eux, plus performants que notre modèle. Toutefois, l’équation de Kayser et Leininger, qui est composée de cinq variables, n'est basée que sur neuf élections (1980–2009). En outre, les modèles allemands présentent un décalage plus court d'un ou deux mois seulement.
Comparaison du modèle proposé avec d'autres modèles

À l'instar de la vaste majorité des structuralistes, nous nous sommes consacrés à l’élaboration d'un modèle dédié à la performance électorale du parti au gouvernement. Mais qu'en est-il maintenant de la possibilité de prédire, au moyen d'un seul modèle, les scores de différents partis lors d'une même élection? Le caractère multipartite du système politique canadien fait en sorte que la seule connaissance des scores du parti sortant n'est pas suffisante pour avoir une vision d'ensemble de la compétition électorale au Canada et des chances de chaque compétiteur. Comme nous l'avons vu, le modèle SUR offre une avenue de recherche intéressante. Le tableau 4 présente trois modèles de ce type. Le premier de ces modèles (S1) emploie des variables identiques à celles de l’équation 1 afin de prédire le pourcentage des voix obtenues par le parti sortant, le principal parti d'opposition (libéral ou conservateur) et le CCF-NPDFootnote 17. On constate qu'un tel modèle produit une équation prévisionnelle tout aussi satisfaisante pour le parti sortant que l’équation 1, mais des résultats très insatisfaisants pour les deux autres partis. Les équations qui leur sont associées n'expliquent qu'une part minime de la variance dans le vote recueilli (moins de 30 pour cent dans les deux cas) et produisent des erreurs substantielles (près de neuf points de pourcentage hors-échantillon pour le principal parti d'opposition et près de cinq points pour le CCF-NPD). Il semble donc que les variables retenues pour construire notre modèle constituent de bons prédicteurs du vote en faveur du parti sortant, mais non du vote en faveur des autres partis. Cela s'explique probablement par le fait que le vote n'allant pas au parti sortant se trouve divisé entre différentes formations politiques. Par ailleurs, les électeurs qui ne sont pas satisfaits du gouvernement en place peuvent aussi décider de s'abstenir plutôt que d'encourager un parti d'opposition.
Modèles de régressions apparemment indépendantes (SUR)

a. Variable dépendante : Pourcentage des voix du parti sortant.
b. Variable dépendante : Pourcentage des voix du principal parti d'opposition (libéral ou conservateur).
c. Variable dépendante : Pourcentage des voix du CCF-NPD.
d. Variable dépendante : Pourcentage des voix des partis restants.
***p < 0,01
**p < 0,05
*p < 0,10
Le second modèle (S2) vise pour sa part à estimer le pourcentage des voix reçues par le parti sortant, le principal parti d'opposition, le CCF-NPD et l'ensemble des formations restantes (donc 100 pour cent des votes consentis lors d'une élection) avec les mêmes variables que l’équation 1, exception faite de la variable d'expérience, qui renvoie désormais à la différence entre l'expérience politique du premier ministre sortant et l'expérience moyenne de tous les autres chefs disposant d'une certaine visibilitéFootnote 18. Ce modèle ne produit guère de meilleurs résultats que le précédent. Encore une fois, l’équation rattachée au parti sortant reste assez précise, mais les équations associées aux autres partis se révèlent très décevantes en termes de variance expliquée et d'erreur de prédiction.
Le troisième et dernier modèle SUR (S3) fait entorse à notre approche « sans sondage » : ce modèle comporte une équation pour le parti sortant en tous points similaire à l’équation 1, mais des équations entièrement fondées sur les intentions de vote récoltées par le principal parti d'opposition et le CCF-NPD lors du troisième mois précédant l’élection. Comme toujours, l’équation pour le parti sortant permet d'obtenir des estimations assez précises. Là où le modèle se démarque, c'est par sa capacité à générer des prédictions relativement satisfaisantes pour le CCF-NPD : l'erreur moyenne absolue hors-échantillon pour les scores de ce parti est de 3,20 points de pourcentage et on peut probablement expliquer une part importante de la magnitude de cette erreur par la performance inattendue du NPD en 2011 (la « vague orange »). En effet, pour ce scrutin, l'erreur hors-échantillon de l’équation S3.3 dépasse les 15 points de pourcentage. Enfin, les résultats sont moins reluisants du côté du principal parti d'opposition : l'erreur moyenne absolue hors-échantillon de l’équation S3.2 s’élève à 4,63 points de pourcentage.
Globalement, les modèles SUR que nous avons mis à l’épreuve ne permettent guère d'obtenir des équations prévisionnelles de qualité similaire pour l'ensemble des principaux partis. Il n'est toutefois pas impossible qu'un modèle SUR employant des combinaisons différentes de variables puisse générer de meilleurs résultats.
Conclusion
Le modèle que nous avons proposé résulte en partie de la combinaison des modèles créés il y a déjà un certain temps par Nadeau et Blais (Reference Nadeau and Blais1993) puis par Bélanger et Godbout (Reference Bélanger and Godbout2010) pour les élections fédérales canadiennes. D'abord, comme l'avaient noté ces auteurs, il semble bel et bien que le chômage constitue la variable macroéconomique la plus saillante au Canada en période électorale. Toutefois, alors que Nadeau et Blais emploient une lecture relative du taux de chômage et Bélanger et Godbout une lecture fixe, nous avons plutôt suggéré de repenser l’évaluation du chômage en termes comparatifs en faisant du marché de l'emploi américain un point de référence pour les électeurs canadiens.
Le temps passé au pouvoir par le parti ministériel comme variable indépendante met pour sa part en évidence l'effet corrosif presque inéluctable des années qui s’écoulent sur les appuis du gouvernement : on remarquera cependant que l'arrivée d'un nouveau premier ministre au sein de l’équipe dirigeante quelques mois ou semaines avant que les décrets d’élection ne soient émis semble avoir pour effet de donner un coup de pouce notable (autour de six points de pourcentage) à la formation ministérielle, ce qui pourrait indiquer qu'une nouvelle figure à la tête du gouvernement vient atténuer l'usure du pouvoir. Bien évidemment, la venue d'un nouveau premier ministre ne garantit en rien la réélection des sortants comme le montrent d'ailleurs les scrutins de 1984 et 1993 où la victoire a échappé à John Turner puis Kim Campbell, qui avaient succédé respectivement à Pierre Trudeau et Brian Mulroney.
L'origine provinciale du premier ministre est de loin la variable ayant le plus d'impact sur le vote populaire en faveur du parti sortant. Lorsque le chef du gouvernement est originaire du Québec et que cela n'est le cas d'aucun de ses concurrents, le parti ministériel peut espérer un gain approchant les 13 points de pourcentage (toutes choses étant égales par ailleurs), largement de quoi déterminer l'issue d'une élection. L'impact de l'expérience relative du premier ministre sur le vote est pour sa part beaucoup plus modeste, mais contribue néanmoins à augmenter la force explicative et la précision de notre modèle.
De manière générale, nous pouvons dire que notre modèle constitue une amélioration par rapport à celui proposé par Bélanger et Godbout : le coefficient de détermination multiple ajusté est de beaucoup supérieur alors que l'erreur moyenne absolue se trouve réduite de plus d'un point. Avec une MAE de 2,95 points de pourcentage pour l'ensemble des scrutins qui ont eu lieu depuis 1953, notre modèle offre un niveau de précision qui se situe même légèrement en deçà de la marge d'erreur typique des trois points généralement attribuée aux sondages d'intention de vote, en faisant par-là une alternative intéressanteFootnote 19. Ceci est d'autant plus vrai à une époque où l'industrie du sondage connaît d'importantes transformations qui mettent en cause la fiabilité de ses estimations. De plus, les modèles politico-économiques possèdent un avantage majeur par rapport aux sondages d'intention de vote, qui constituent toujours l'approche « prévisionnelle »Footnote 20 dominante au sein des États démocratiques (Lewis-Beck et Tien, Reference Lewis-Beck, Tien, Clements and Hendry2011: 658; Turcotte, Reference Turcotte, Pammett and Dornan2011: 196). En effet, la plupart des sondages électoraux ne font qu'enregistrer les intentions de vote et non les raisons qui sous-tendent ces intentions, alors que les modèles structurels sont pour leur part fondés sur une théorie du vote (Fair, Reference Fair2012: 7; Lewis-Beck, Reference Lewis-Beck2005: 148).
Par ailleurs, les recherches futures devraient davantage explorer la possibilité de construire des systèmes d’équations permettant d'obtenir des estimations pour l'ensemble des principaux partis lors d'une course électorale et non seulement pour la formation (ou la coalition) sortante. Nous avons tenté, au moyen de modèles SUR, de jauger les capacités et le potentiel d'une telle approche et, bien que les résultats ne soient pas à la hauteur de nos attentes, l'analyse de régressions apparemment indépendantes reste un sentier encore relativement peu emprunté qui mériterait de recevoir plus d'attention.
En terminant, notons que Cuzán (Reference Cuzán2015) a énoncé l'existence de lois (ou régularités) de la politique qui concernent autant les démocraties que les régimes dictatoriaux. L'idée selon laquelle l'exercice du pouvoir aurait un coût renvoie à ce que Cuzán appelle la « loi du rétrécissement des appuis » (the law of shrinking support), une régularité que soulignent de nombreux auteurs et qui est soutenue par notre modèle dans le cas des élections fédérales au Canada. L'avantage dont jouissent les sortants à leur première tentative de réélection – ce que Jackman (Reference Jackman1995: 352) qualifie d’« effet lune de miel » – est une autre des lois énoncées par Cuzán. Bien que cette loi ne soit pas explicitement intégrée à notre modèle, plusieurs prévisionnistes, comme nous l'avons vu, réservent une place à l’incumbency dans leurs équations. À notre avis, l'impact des conditions économiques sur le vote devrait également être considéré comme une des lois de la politique, et ce, même si tous les auteurs ne s'entendent pas sur la nature exacte du vote économique. Par ailleurs, selon Cuzán, les politologues se montrent encore trop réticents à aborder avec assurance les connaissances qui font consensus en science politique. En intégrant certaines de ces connaissances à leurs modèles et en montrant qu'il est possible d'estimer avec précision les résultats électoraux, nous croyons que les prévisionnistes peuvent contribuer à rehausser cette confiance qui semble actuellement faire défaut dans la discipline.
Supplementary material
The supplementary material for this article can be found at https://doi.org/10.1017/S0008423918000860