

Introduction
La statistique est la science qui consiste à recueillir, analyser et interpréter un jeu de donnéesFootnote 1 pour mieux comprendre un phénomène. Elle s’appuie sur la théorie des probabilités pour interpréter les données.
Les informations de nature statistique, facilement accessibles de nos jours, influencent nombre de nos décisions. Pensons à la décision de prendre un parapluie pour nous rendre au bureau le matin, d’investir financièrement dans une nouvelle entreprise prometteuse, ou encore de recevoir une cinquième dose de vaccin contre la COVID-19.
La représentation graphique de données peut induire en erreur. Le cas classique est celui d’une association qui laisse croire à une relation de cause à effet. La figure 1 en fournit un exemple, qui met en relation la consommation de glace en kilogrammes et le nombre de décès par noyade en Espagne en 2018Footnote 2. Il serait évidemment erroné d’en conclure que plus une personne consomme de glace, plus elle risque de se noyer. Le lien apparent entre ces deux variables s’explique par l’influence de tiers facteurs non pris en compte. La chaleur qui caractérise les étés espagnols constitue vraisemblablement l’un de ces facteurs.
Exemple de graphique pouvant prêter à confusion.

Figure 1. Description longue
L’axe horizontal répertorie les mois de janvier à décembre. L’axe vertical gauche mesure les Drowning Deaths de 0 à 120. L’axe vertical droit mesure la Ice Cream Consumption In Kilograms de 0 à 30 M.
La courbe rouge (consommation de glace) commence à environ 5 M en janvier, chute légèrement en février, puis grimpe de façon parabolique pour atteindre un pic à environ 29 M en juin, avant de redescendre brusquement vers 3 M en novembre et décembre.
La courbe violette (décès par noyade) suit une trajectoire similaire mais décalée. Elle commence à environ 30 en janvier, atteint son point le plus bas en février, puis augmente progressivement pour culminer à environ 110 en juillet, soit un mois après le pic de consommation de glace. Elle redescend ensuite pour atteindre environ 25 en novembre.
Les deux courbes présentent une forme de cloche centrée sur la période estivale, illustrant une corrélation statistique sans lien de causalité direct.
On trouve des exemples de graphiques qui prêtent à confusion et de mésusage de données statistiques dans plusieurs sphères d’activité, par exemple en publicité, en politique, voire en sciencesFootnote 3. Le droit ne fait pas exception. Bien que les juges reproduisent rarement un graphique statistique dans le compte-rendu d’une décision, plusieurs décisions judiciaires reposent sur une utilisation erronée d’une statistique présentée par l’une ou l’autre des parties impliquées. Ce sont ces erreurs dont il sera question dans cet essai et de moyens susceptibles d’en réduire la fréquence.
Des notions de base de la théorie des probabilités seront d’abord présentées, un passage obligé pour comprendre les exemples de mauvais usage de données statistiques tirés du droit (partie 1). Des solutions visant à éviter que de telles situations ne se reproduisent seront ensuite exposées (partie 2), suivies d’une brève conclusion qui rappellera la nécessité d’étudier leur efficacité avant de les implanter.
1. Notions de la théorie des probabilités et applications erronées
Afin de comprendre les exemples, tantôt fictifs tantôt réels, d’emploi erroné de données statistiques présentés dans cette partie, il est utile de revoir brièvement le concept de probabilité (1.1) et deux règles probabilistes de base (1.2).
1.1. Le concept de probabilité
1.1.1. Conceptions fréquentielle et subjective de la probabilité, et opérations de base
La probabilité d’un événement est une quantification de son caractère probable. Elle prend une valeur entre 0 et 1; plus la valeur est grande, plus le risque, ou la chance, que l’événement se produise est élevé.
Plus formellement, soit A un événement d’intérêt. Selon l’interprétation fréquentielle, la probabilité que A se réalise, notée P (A), est la fréquence relative à laquelle A s’observe dans un grand nombre d’expériences identiques. Supposons que A soit le fait pour un individu d’avoir développé une maladie donnée. Mille personnes choisies au hasard subissent un test diagnostique pour savoir si elles en sont atteintes ou non. Si la maladie est décelée chez 23 d’entre elles, alors P (A) = 23 / 1 000. La probabilité qu’un individu choisi au hasard soit atteint de cette maladie est alors estimée à 2,3 %.
Si A et B sont deux événements mutuellement exclusifs, en ce sens qu’ils ne peuvent survenir simultanément, alors la probabilité que l’un ou l’autre se produise s’obtient de la somme de leur probabilité respective : P (A ou B) = P (A) + P (B). Par exemple, si la probabilité de décéder d’un infarctus du myocarde un lundi est estimée à 0,25, et celle de décéder durant la fin de semaine, à 0,13, alors la probabilité de décéder d’un infarctus un lundi ou en fin de semaine s’élève à 0,25 + 0,13 = 0,38 = 38 %.
Enfin, notons par A c l’événement contraire de A (son complément). Par définition, ces deux événements sont mutuellement exclusifs. Par ailleurs, A ou A c se réalisera. Par conséquent, selon la règle précédente : P (A ou A c) = P (A) + P (A c) = 1 → P (A c) = 1 – P (A). Ainsi, la probabilité qu’un individu choisi au hasard ne soit pas atteint de la maladie dont il est question plus haut est estimée à 1 – 2,3 % = 97,7 %.
La définition fréquentielle de la probabilité sied mal au droit. Il est en effet difficile d’y transposer l’idée d’une expérience que l’on répète plusieurs fois dans des conditions constantes. Dans ce contexte, on en réfère plutôt à la conception subjective de la probabilité qui reflète notre jugement quant à la vraisemblance d’un événementFootnote 4. La probabilité constitue alors un moyen de traduire numériquement notre degré de croyance en une affirmation. Par exemple, un étudiant pourrait estimer à 95 % la probabilité qu’il réussisse son prochain examen parce qu’il juge s’y être bien préparé.
La preuve judiciaire a pour but de convaincre le tribunal de l’existence ou non d’un fait. Elle s’inscrit dans une procédure qui met en jeu divers dispositifs, dont l’attribution du fardeau de la preuve et le degré de preuve exigéFootnote 5. Au Québec, l’obligation de convaincre incombe au demandeur dans une cause civile (art. 2803 C.c.Q.). Le degré de preuve correspond à la force probante requise par le tribunal pour donner raison au demandeur. La norme est la prépondérance de la preuve ou balance des probabilités; sauf exception, il suffit alors de montrer que le fait allégué est plus probable qu’improbable (art. 2804 C.c.Q.). En termes probabilistes, il faut convaincre le juge que la probabilité du fait est supérieure à 50 %Footnote 6.
Une probabilité soumise en preuve proviendra d’une publication scientifique pertinente ou reflètera l’opinion d’un expert. Le recours à des preuves de cette nature commande la prudence, comme l’illustre l’exemple qui suit, inspiré du paradoxe des gatecrashers Footnote 7.
1.1.2. Exemple (fictif) de mésusage d’une probabilité
Un professeur de droit s’étonne de la moyenne élevée obtenue par son groupe d’étudiants à l’examen final, d’autant plus que le groupe était plutôt faible cette année. Il soupçonne certains étudiants d’avoir triché. Fouillant dans la littérature scientifique, il découvre une étude récente, solide sur le plan méthodologique, qui révèle que 60 % des étudiants en droit trichent aux examens. Frustré de s’être fait avoir, il veut convaincre le directeur du programme d’attribuer un échec à tous les tricheurs pour les punir.
Selon l’étude (fictive) précitée, la probabilité qu’un étudiant choisi au hasard ait triché s’élève à 60 %. Cette valeur étant supérieure à 50 %, il est déclaré tricheur selon la balance des probabilités. Comme ce raisonnement s’applique à tous les étudiants du groupe, tous échoueraient au cours. Un tel raisonnement est manifestement insenséFootnote 8.
Cet exemple illustre le danger de décider du sort d’un individu en lui appliquant un énoncé général qui caractérise un groupe auquel il appartient. Comme l’énonce le juge Wagner dans l’arrêt Benhaim c St-Germain : « Les généralisations statistiques ne permettent pas de trancher des cas précis »Footnote 9. Erica Beecher-Monas exprime la même idée en ces termes : « Statistical inference from the general to the specific is simply not something science can do »Footnote 10. Avant de condamner un étudiant pour tricherie, il faudrait disposer d’informations qui le concernent personnellement.
Supposons que les soupçons du professeur de droit soient dirigés vers M. ImbroglioneFootnote 11. Cet étudiant a très bien réussi l’examen final (94 %), alors qu’il avait échoué à l’examen de mi-session. Le professeur amasse graduellement un ensemble d’indices défavorables à M. Imbroglione. Il découvre que son visa étudiant n’est plus valide et qu’il a été reconnu coupable de vol à l’étalage à deux reprises. Une étudiante l’informe qu’à l’insistance de M. Imbroglione, elle avait accepté d’inscrire son nom sur un texte auquel il n’avait pas contribué. D’une autre, il apprend que M. Imbroglione avait fait la fête toute la nuit la veille de l’examen et n’était entré qu’à 5 h du matin, ce que sa colocataire confirme. Enfin, le surveillant de l’examen croit avoir vu M. Imbroglione consulter son téléphone cellulaire pendant l’examen.
Combinés à la statistique de 60 % précitée, ces faits, spécifiques à M. Imbroglione, sauront ou non convaincre le directeur du programme qu’il mérite un échecFootnote 12. Idéalement, le directeur tirera sa conclusion en tenant compte de l’ensemble des faits portés à son attention, après avoir soupesé leur force probante.
1.2. Deux règles probabilistes au cœur d’affaires judiciaires célèbres
1.2.1. La règle du produit
Soient A et B, deux événements indépendants en ce sens que la survenance de l’un n’influence pas la survenance de l’autreFootnote 13. La probabilité que l’un et l’autre événements surviennent est égale au produit de leur probabilité respective : P (A et B) = P (A) × P (B). À titre d’exemple, supposons que la probabilité de décéder à la suite de complications d’une fracture de la hanche s’élève à 45 % chez les femmes de plus de 70 ans. Deux de vos connaissances, âgées respectivement de 72 et de 76 ans, ont récemment subi une fracture de la hanche. La probabilité que l’une et l’autre en décèdent = la probabilité que l’une décède × la probabilité que l’autre décède = 0,45 × 0,45, soit environ 20 %.
La règle du produit, simple en apparence, a été maintes fois mal utilisée en droitFootnote 14, avec de lourdes conséquences dans certains cas, dont des condamnations injustifiées. L’affaire R. v Sally Clark, au Royaume-Uni, est l’une des plus souvent citées en exempleFootnote 15. Le fils de Sally Clark, Harry, décède en janvier 1998 à l’âge de deux mois. Les instances policières au dossier se souviennent alors que le premier fils de Clark, Christopher, est lui aussi décédé quelques mois après sa naissance, deux ans plus tôt. Le rapport d’autopsie avait conclu que Christopher était décédé du syndrome de mort subite du nourrisson (MSN). Sally Clark, alors avocate à Londres âgée de 26 ans, est accusée du meurtre de ses deux fils et condamnée.
La condamnation repose sur le témoignage du Dr Roy Meadow, un pédiatre de renom. S’appuyant sur des données londoniennes non contestées, il établit que la probabilité d’une MSN au sein d’une famille semblable à celle de Clark est de 1 sur 8 543. Appliquant la règle du produit, il affirme que la probabilité de deux MSN dans la même famille n’est que de 1 sur 73 millions (8 543 × 8 543). Le magistrat qualifie cette statistique de convaincante (en anglais, compelling). La conviction est confirmée en appel.
La règle du produit est mal appliquée si les deux événements ne sont pas indépendants. Les deux décès pourraient s’expliquer par des prédispositions génétiques ou par la présence dans l’air d’un agent infectieux. Après avoir passé trois ans en prison, Sally Clark est libérée en janvier 2003 sur la base du rapport d’un pathologiste qui révélait qu’Harry était infecté d’un staphylocoque doré (S. aureus Footnote 16). Cette information avait été cachée à la défense. Sally Clark décède en 2007 d’une intoxication alcoolique.
Mais, dans l’affaire Clark, d’autres erreurs statistiques ont été commises.
Supposons que l’on puisse établir que la probabilité d’une double mort subite du nourrisson n’est pas de 1 sur 73 millions, mais en réalité, disons, de 1 sur 15 millions. Il s’agit encore d’une probabilité très faible. À elle seule, cependant, cette probabilité n’a aucune valeur probante. Prise isolément, on ne peut rien en déduire. Pour conclure, il faudrait la comparer à la probabilité d’un double assassinat par la mère des nourrissonsFootnote 17. Si cette probabilité était, par exemple, de 1 sur 25 millions, alors l’hypothèse selon laquelle les enfants sont décédés de mort naturelle (MSN) est plus vraisemblable que celle voulant que leur mère leur ait enlevé la vie.
Dans cette cause comme dans d’autresFootnote 18, le tribunal a été victime du sophisme du procureur (en anglais, prosecutor’s fallacy). Ce raisonnement, « faux malgré une apparence de vérité »Footnote 19, doit son nom à son utilisation par l’accusation pour prouver la culpabilité d’un accuséFootnote 20. Il survient lorsque le procureur établit une équivalence entre, d’une part, la probabilité que les faits incriminant l’accusé aient été observés s’il est innocent et, d’autre part, la probabilité que la personne soit innocente étant donné les faits observés. Un procureur pourrait dire, par exemple : Le coupable possède un trait génétique qui n’est présent que chez 10 % de la population. L’accusé possède ce trait. Il y a donc 90 % de chance qu’il soit coupable.
La nature fallacieuse de ce raisonnement devient évidente lorsque l’on délaisse momentanément la sphère juridique pour entrer dans l’univers aviaire : La plupart des cygnes sont blancs. J’aperçois un oiseau blanc, donc c’est un cygne.
Notons par E l’événement correspondant à l’observation d’un indice mettant en cause l’accusé (par exemple une concordance ADN ou, dans le cas de Sally Clark, le décès de ses deux fils), et par I l’événement correspondant à l’innocence du suspect. On est alors en présence de deux probabilités, dites conditionnelles :
P (E / I) = la probabilité que l’indice soit observé bien que l’accusé soit innocent, et
P (I / E) = la probabilité que l’accusé soit innocent malgré l’indice observé.
La seconde probabilité est celle qui reflète la culpabilité ou l’innocence de l’accusé. En général, P (E / I) est très faible (comme dans Clark : 1 sur 73 millions selon la preuve apportée par le Dr Roy Meadow). Le sophisme du procureur consiste à traiter ces deux probabilités comme étant équivalentes et à affirmer que, par conséquent, P (I / E) est elle aussi très faible. Ayant observé un événement très improbable si l’accusé est innocent, il est déclaré coupable.
Le sophisme du procureur pourrait être évité en appliquant le théorème de Bayes.
1.2.2. Le théorème de BayesFootnote 21
Ce théorème permet de calculer la probabilité conditionnelle d’un événement A, sachant (ou étant donné) que l’événement B s’est réalisé. Notée P (A / B), elle s’obtient de la formule suivante :

P (A) et P (B) sont appelées des probabilités a priori, et P (A / B) et P (B / A), des probabilités a posteriori. Placé dans le contexte d’un procès, le théorème prendrait la forme suivante :
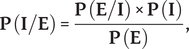
où P (I) est la probabilité de l’innocence de l’accusé a priori, indépendamment des indices récoltés, et P (E), la probabilité d’observer l’indice sur une personne quelconque, qu’elle soit coupable ou innocente. La formule précédente montre que le rapport de ces deux probabilités affecte la probabilité de l’innocence de l’accusé. Le sophisme du procureur ignore l’effet de ce rapport.
Considérons la question suivante posée à des étudiants et professeurs de l’École de médecine de HarvardFootnote 22 : Une personne sur 1 000 est atteinte d’une maladie cardiaque particulière. Il existe un test pour détecter cette maladie. Le test détecte la présence de la maladie chez toutes les personnes qui en sont atteintes (sensibilité de 100 %). Cependant, 5 % des personnes qui n’ont pas la maladie sont à tort diagnostiquées comme en étant atteintes (spécificité de 95 %). Si une personne choisie au hasard teste positive, quelle est la probabilité qu’elle soit réellement atteinte de cette maladie?
Près de la moitié des personnes interrogées ont répondu 95 %. La bonne réponse est environ 2 %. Voici comment l’obtenir avec le théorème de Bayes : Soit A l’événement « la personne a la maladie » et B l’événement « le test est positif ». On cherche P (A / B), la probabilité de A, sachant B. La question posée fournit les informations suivantes :

Alors, en vertu du théorème de Bayes,

A priori, c.-à-d. si l’on ne dispose d’aucune information sur la personne, la probabilité qu’elle soit atteinte est de 1 sur 1 000 (0,1 %), comme toute autre personne de la population. A posteriori, c.-à-d. après avoir découvert que son test est positif, la probabilité est révisée à la hausse, à 2 %. Lorsque les personnes ont répondu 95 % à la question posée, elles ont été victimes d’une autre erreur courante, appelée oubli de la fréquence de base (en anglais, base-rate neglect fallacy). Elles ont omis de prendre en considération la très faible probabilité d’avoir la maladie (1 sur 1 000) qui constitue le point de départ du raisonnement.
Les personnes moins à l’aise avec les formules mathématiques préfèreront peut-être une représentation visuelle du raisonnement (cf. figure 2), appelée arbre de décision. Supposons que 100 000 personnes choisies au hasard soient soumises au test de dépistage. La figure révèle que 100 personnes sont atteintes de la maladie (en rouge) parmi les 5 095 (c.-à-d. 100 + 4 995) personnes chez qui le test est positif (en bleu). La probabilité qu’une personne choisie au hasard soit atteinte de la maladie si son test est positif est donc égale à 100 / 5 095 = 0,0196.
Arbre de décision illustrant le théorème de Bayes.
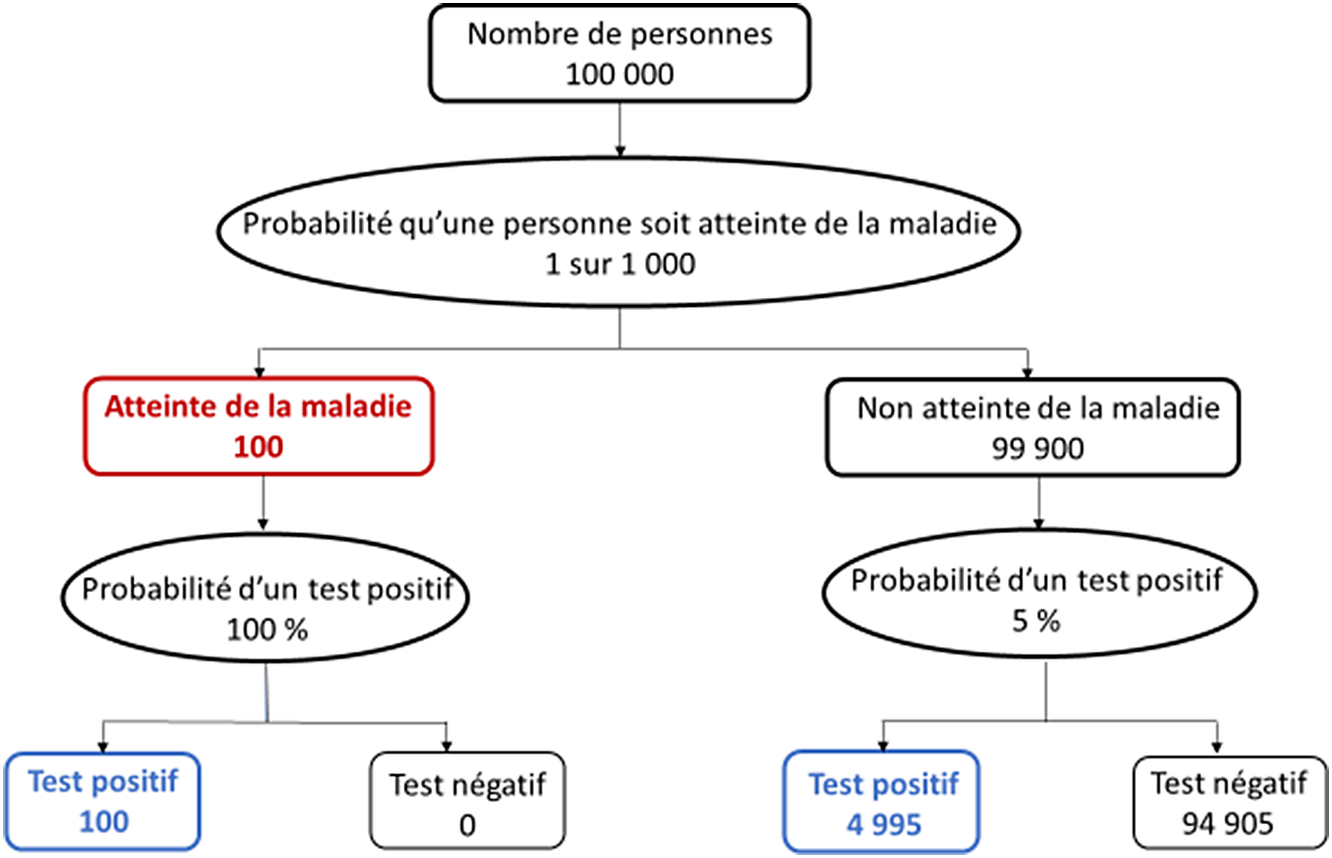
Figure 2. Description longue
L’arbre commence au sommet par un rectangle indiquant un Nombre de personnes de 100 000. Une flèche descend vers une ellipse centrale indiquant une Probabilité qu’une personne soit atteinte de la maladie de 1 sur 1 000.
De là, deux branches se séparent.
À gauche, un rectangle rouge indique Atteinte de la maladie pour 100 personnes. Une flèche descend vers une ellipse indiquant une Probabilité d’un test positif de 100 %. Ce chemin se divise en deux résultats finaux. Un rectangle bleu à gauche indique Test positif pour 100 personnes et un rectangle noir à droite indique Test négatif pour 0 personne.
À droite, un rectangle noir indique Non atteinte de la maladie pour 99 900 personnes. Une flèche descend vers une ellipse indiquant une Probabilité d’un test positif de 5 %. Ce chemin se divise en deux résultats finaux. Un rectangle bleu à gauche indique Test positif pour 4 995 personnes et un rectangle noir à droite indique Test négatif pour 94 905 personnes.
En résumé, le théorème de Bayes permet d’actualiser l’estimation d’une probabilité au fur et à mesure que de nouveaux éléments de preuve s’accumulent. Le degré de croyance en la culpabilité de l’accusé ou la responsabilité du défendeur s’affine à la lumière des nouvelles informations produites en preuve.
Les premières tentatives de recourir au théorème de Bayes pour éviter la condamnation injustifiée d’un accusé ont été accueillies avec scepticisme, comme en témoigne l’extrait suivant tiré de l’affaire R. v Adams Footnote 23 :
Jurors evaluate evidence and reach a conclusion not by means of a formula, mathematical or otherwise, but by the joint application of their individual common sense and knowledge of the world to the evidence before them. [T]o introduce Bayes Theorem, or any similar method, into a criminal trial plunges the jury into inappropriate and unnecessary realms of theory and complexity deflecting them from their proper task.
Cette opinion est réitérée lors du nouveau procès d’Adams : le théorème de Bayes y est alors qualifié d’approche statistique qui contraste avec le sens commun « which juries in this country have used for many, many years, pretty satisfactorily »Footnote 24.
Le théorème de Bayes a aussi été critiqué par la doctrine. Laurence TribeFootnote 25, par exemple, rejette, non seulement l’utilisation de ce théorème dans un procès, mais tout recours aux mathématiques dans les procédures judiciaires. Ses arguments, qui ne seront pas repris ici, ont été amplement commentés et rejetés à leur tourFootnote 26. En revanche, alors qu’il était professeur à l’université de l’Alberta, Russell Brown soutenait la position de Tribe, affirmant que « Bayesian methodology suffers from several defects, […] making it incompatible with legal fact-finding »Footnote 27. Entre autres arguments, il souligne, avec raison, que le résultat de la formule de Bayes dépend de la valeur des probabilités a priori :
Everything that follows — the continual updates of the prior estimate in light of discovered bits of evidence relevant to cause-in-fact, and the final modification of the assessment of the proposition’s likelihood — depends upon that starting point. […] In other words, the new statistical probability is just as suspect as the prior.Footnote 28
À cela, Fenton et Neil, deux ardents défenseurs de l’approche bayésienne, rétorquent qu’il suffit d’assigner aux probabilités a priori un ensemble de valeurs sur lequel les deux parties s’entendent, puis de refaire les calculs autant de fois que nécessaire pour voir l’impact réel de l’incertitude qui entoure ces probabilitésFootnote 29. Selon leur expérience, il est rare que cette incertitude modifie substantiellement la conclusion. C’est parce que le poids des preuves déposées au tribunal est souvent supérieur à celui de l’estimation initiale. Dans les cas de preuves légères, plus rares en pratique, la valeur attribuée à une probabilité a priori pourra modifier la conclusion.
Un second défaut que Brown attribue à l’approche bayésienne repose sur l’aptitude limitée de l’homme en calcul (empirical limitations of human computational capacity). Il fait valoir qu’il y a rarement un seul élément de preuve dans un procès, c.-à-d. un seul E, mais plutôt un ensemble d’éléments E 1, E 2, …, E n. Dans l’affaire Benhaim c St-Germain relativement complexe sur le plan médical, l’enjeu était de déterminer si le cancer pulmonaire de M. Émond était au stade I – II ou au stade III – IV lors de la première radiographie. Divers éléments liés à M. ÉmondFootnote 30 et aux cancers pulmonaires en généralFootnote 31 ont été soulevés par l’une ou l’autre des parties. Dans des cas semblables, il serait certes difficile d’estimer la probabilité recherchée, P (I / E 1, E 2, E 3, …), dont le calcul ferait intervenir une multitude de variables. Brown l’affirme ainsi : « The notion of a fact-finder who continually and mathematically refines accumulating data is simply implausible Footnote 32 ». Il est incontestable que la formule de Bayes se complique rapidement en présence de multiples éléments de preuve en raison de leurs interdépendances complexes. Ces interdépendances peuvent être illustrées graphiquement au moyen d’un réseau bayésienFootnote 33 et analysées à l’aide d’un logiciel conçu à cette finFootnote 34.
Certains pourraient objecter que l’issue d’un litige civil ou d’un procès criminel repose sur des valeurs sorties d’un logiciel, sans réellement comprendre comment elles ont été calculées. Pour contrer cette objection, Fenton, Neil et Berger établissent un parallèle avec la calculatrice de poche. Ils soulignent que rares sont les personnes qui ressentent le besoin de connaître les nombreuses opérations mathématiques qui entrent dans le calcul d’une longue divisionFootnote 35.
Fenton et ses collaborateurs ne sont pas les seuls à considérer que l’approche bayésienne constitue un moyen efficace pour résoudre des litiges ou des affaires criminelles complexes. Par exemple, au sujet du théorème de Bayes, les professeurs de droit Saks et Koehler écrivent :
The Bayesian approach can have a clarifying effect on ones thinking about evidence. By using Bayes Theorem, we can see what information about the evidence is needed, where the absence of data is replaced by assumptions of the witnesses or fact findings, and what impact the evidence should have on our preexisting beliefs. In contrast, the intuitive decision-maker has few helpful guideposts for updating beliefs, and risks falling victim to some of the many biases associated with the heuristic strategies intuitive decision-makers employ.Footnote 36
L’application du théorème de Bayes dans l’affaire Benhaim aurait peut-être amené la juge de première instance, ainsi que la Cour suprême, à conclure que la faute (admise) des docteurs Benhaim et O’Donovan – soit l’omission d’effectuer des examens plus poussés du nodule constaté sur les radiographies, lesquels auraient pu permettre de diagnostiquer en temps utile le cancer pulmonaire – avait causé la mort de M. Émond, rejoignant ainsi l’avis majoritaire de la Cour d’appel.
Dans cette première partie, nous avons exposé des principes de base de la théorie des probabilités et montré, par quelques exemples, qu’une probabilité mal employée peut être préjudiciable. Le théorème de Bayes est un moyen d’éviter de telles erreurs dans les affaires judiciaires. Force est toutefois d’admettre que son utilisation dans le cadre d’un litige ou d’un procès complexe n’est pas simple et risque de rencontrer quelques résistances. D’autres moyens pourraient-ils contribuer à ce que des données scientifiques pertinentes à une affaire soient bien utilisées au tribunal? La seconde partie de cet essai en examine deux : la formation (2.1) et le recours à l’expertise statistique (2.2).
2. Comment éviter les erreurs judiciaires du passé?
2.1. La formation
Des études montrent que l’intuition est sujette à l’erreur lorsqu’un raisonnement fait intervenir des probabilitésFootnote 37, d’autant plus si celles-ci sont petites. Considérons les deux énoncés suivantsFootnote 38 :
-
i) Sur un million de personnes, 1 000 risquent de décéder après avoir reçu le traitement A, mais 10 seulement après le traitement B.
-
ii) La probabilité de décéder après avoir reçu le traitement A est égale à 0,001, tandis que celle de décéder après le traitement B est égale à 0,00001.
Bien que ces énoncés soient équivalents, plusieurs seraient d’avis que la supériorité du traitement B par rapport au traitement A est plus évidente dans le premier énoncé que dans le second.
La sélection des personnes appelées à faire partie d’un jury doit découler d’un processus aléatoireFootnote 39. Il est donc peu probable que plusieurs jurés, voire un seul, aient a priori une bonne connaissance du concept de probabilité et des règles qui permettent de manier ces probabilités.
En revanche, considérant la place grandissante qu’occupe la preuve scientifique en droit pénal et dans de nombreux domaines du droit civilFootnote 40, les juges et les avocats devraient connaître les bases de la statistique et de la théorie des probabilités. Le juge des faits doit pouvoir comprendre les preuves et les arguments scientifiques qui lui sont présentés. Quant aux avocats, ils auront de la difficulté « à exercer efficacement leurs fonctions d’examiner, d’éprouver et de contester la preuve »Footnote 41 si son objet dépasse leur compétence. La formation, qu’elle soit formelle (2.1.1) ou acquise avec des guides d’autoapprentissage (2.1.2), pourrait soutenir les juristes dans ces aspects de leur profession. Pundik le souligne : « While the difficulties of using statistics in court are genuine, they are technical and may be addressed through better education of the legal profession […] »Footnote 42.
2.1.1. Cours universitaires
Selon Christopher Slobogin, rares sont les programmes de formation universitaire en droit qui consacrent même quelques heures aux notions statistiques et probabilistes de base : « Whatever the truth of the old saw that lawyers are lawyers because they did not like math and the sciences, it is clear that most lawyers have not had special training in statistics »Footnote 43. Un minimum de formation nous semble nécessaire. Cela permettrait en outre d’atténuer la crainte que les tribunaux rendent mécaniquement des verdicts par formule, et celle des avocats d’avoir à expliquer des concepts mathématiques qu’ils ne comprennent pasFootnote 44. Défenseur d’une formation minimale en statistique pour les juges, Overstall écrit : « The real possibility of a serious miscarriage of justice requires that judges stop denying their math phobia »Footnote 45. Il ne s’agirait pas de convertir les juristes en experts statistiques, mais simplement de leur inculquer suffisamment de connaissances liées au raisonnement probabiliste pour qu’ils deviennent des « consommateurs intelligents d’informations scientifiques »Footnote 46 [notre traduction].
2.1.2. Guides d’autoapprentissage
À défaut d’avoir appris les notions de base de la statistique et de la théorie des probabilités durant leur cursus universitaire en droit, les juristes intéressés pourraient consulter des ressources de formation dans lesquelles ces notions sont exposées. Le Manuel scientifique à l’intention des juges canadiens, produit par l’Institut national de la magistrature (INM), en est uneFootnote 47. Nous avons parcouru ce manuel et y avons relevé des passages erronés ou, à tout le moins, susceptibles de créer de la confusion entre les différents acteurs d’un litige en responsabilité médicale. Avant d’en donner des exemples, et dans le but d’en faciliter la compréhension, nous digressons momentanément pour expliquer le déroulement d’un test statistique d’hypothèse.
Effectuer un test d’hypothèse consiste à confronter deux hypothèses – l’hypothèse dite nulle et l’hypothèse dite alternative. L’hypothèse alternative est généralement celle que l’on veut démontrer. Il pourra s’agir de prouver, par exemple, qu’un nouveau traitement est plus efficace que le traitement usuel, ou que l’exposition fréquente à des jeux vidéo violents à l’adolescence augmente le risque d’être violent à l’âge adulte.
On commence par poser l’hypothèse nulle voulant qu’il n’y ait pas de différence entre les deux traitements ou pas de relation entre les deux variables. L’hypothèse nulle est présumée vraie jusqu’à preuve du contraire, c.-à-d. jusqu’à ce que l’on démontre, statistiquement, qu’elle est peu probableFootnote 48. On procède ensuite à une collecte de données sur un échantillon représentatif de la population cible. Le résultat généré par l’échantillon sert à juger de la vraisemblance de l’hypothèse nulle. Si ce résultat est peu compatible avec celle-ci, elle est alors rejetée au profit de l’hypothèse alternative. Précisément, si la probabilité d’observer un résultat à ce point éloigné de celui prévu par l’hypothèse nulle est petite (traditionnellement, inférieure à 5 %), on rejette l’hypothèse nulle pour accepter l’hypothèse alternative. Le cas échéant, on conclurait, avec un niveau de confiance de 95 %, que le nouveau traitement est supérieur au traitement usuel ou que l’exposition en bas âge à des scènes de violence, même fictives, augmente le risque d’être violent une fois adulte.
Retournant au Manuel scientifique de l’INM, à la page 52, on peut lire qu’« [e]n matière de vérification des hypothèses statistiques, […], les scientifiques ne rejett[e]nt […] l’hypothèse nulle que s’ils sont certains à au moins 95 % qu’elle est fausse » [nous soulignons]. Il faudrait dire : « s’ils ont confiance à au moins 95 % qu’elle est fausse ». Il s’agit d’un niveau de confiance et non de certitude.
Plus loin (page 91), les auteurs soulignent l’importance pour le juge des faits de se préoccuper de la fiabilité des données sur lesquelles repose une affirmation. Ils décrivent deux attributs des données – leur exactitude et leur précision – qu’ils illustrent au moyen des deux cibles reproduites dans le panneau gauche de la figure 3. En médecine, d’où proviennent généralement les experts appelés à témoigner dans une cause en responsabilité médicale, on se réfère plutôt à la fiabilité et à la validité des données. Ces concepts sont typiquement illustrés dans le panneau droit de la figure. Dans ce panneau, des points rapprochés (peu importe où ils se situent) témoignent de la fiabilité de la mesure (c.-à-d. de son caractère reproductible), tandis que des points regroupés près de la cible témoignent de sa validité (c.-à-d. de sa capacité à mesurer ce qu’elle est censée mesurer). En revanche, ce que l’on doit déduire de la position des points dans le panneau gauche n’est pas clair. En outre, le terme fiabilité prend un sens différent dans les deux panneaux, ce qui peut créer une certaine confusion. À gauche, il englobe exactitude et précision, tandis qu’à droite, il ne renvoie qu’à l’un des deux concepts. Ce constat appuie l’affirmation de Beecher-Monas voulant que « [s]cientists and jurists may appear to speak the same language, but they often mean very different things »Footnote 49.
Terminologie employée pour décrire la qualité des données.
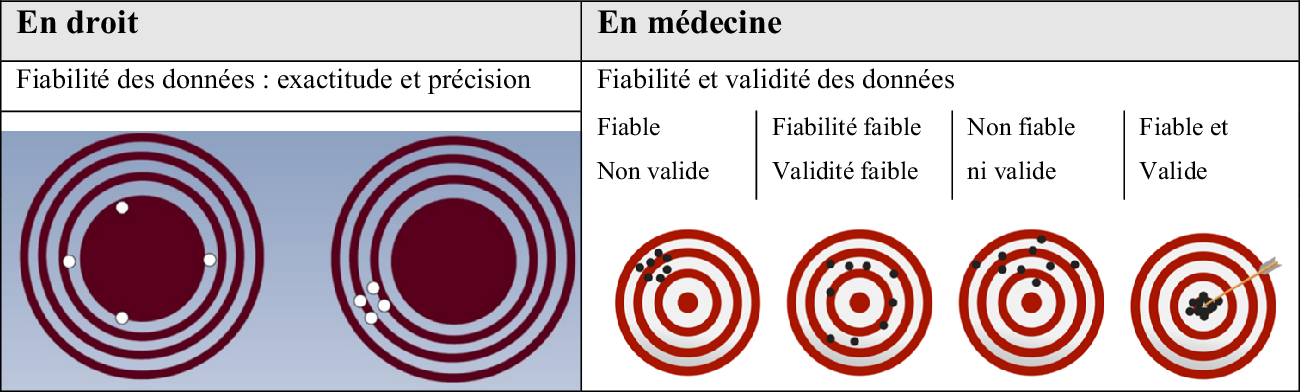
Figure 3. Description longue
Le diagramme est divisé en deux sections distinctes.
Section de gauche intitulée En droit. Sous le titre Fiabilité des données exactitude et précision se trouvent deux cibles.
* La première cible montre quatre points blancs dispersés sur l’anneau extérieur.
* La deuxième cible montre quatre points blancs groupés de manière serrée sur le bord gauche de l’anneau extérieur.
Section de droite intitulée En médecine. Sous le titre Fiabilité et validité des données se trouvent quatre cibles avec des étiquettes textuelles au-dessus.
* Première cible. Étiquetée Fiable Non valide. Les points noirs sont groupés de manière serrée mais loin du centre dans le quadrant supérieur gauche.
* Deuxième cible. Étiquetée Fiabilité faible Validité faible. Les points noirs sont dispersés de manière aléatoire sur tous les anneaux de la cible.
* Troisième cible. Étiquetée Non fiable ni valide. Les points noirs sont dispersés principalement dans la moitié supérieure de la cible sans regroupement.
* Quatrième cible. Étiquetée Fiable et Valide. Une flèche est plantée exactement au centre de la cible où tous les points noirs sont regroupés de manière dense.
À la page 108 du Manuel scientifique, les auteurs décrivent une situation fictive dans laquelle la demanderesse prétend que le cancer qu’elle a développé résulte de son exposition chronique à un produit toxique présent dans son environnement de travail. Ils décrivent une étude cas-témoin dans laquelle des personnes atteintes de la maladie sont comparées à des personnes non atteintes en regard de leur exposition au produit en question. Ils ajoutent que cela permettra de calculer le risque relatif, une mesure de la relation entre la prévalence du cancer dont souffre la demanderesse et l’exposition au produit suspecté. Or, une étude cas-témoin ne permet pas d’estimer un risque relatif; elle fournit un rapport de cotes (en anglais, odds ratio) qui s’interprète différemment du risque relatif. Une étude de cohorte prospective permettrait en revanche d’estimer ce dernierFootnote 50.
Enfin, toujours à la page 108, les auteurs décrivent une autre étude, sur des rats cette fois, visant elle aussi à élucider la relation entre le cancer de la demanderesse et l’exposition au produit toxique. Ils expliquent qu’en raison du faible nombre de rats dans l’étude, « l’hypothèse nulle statistique sera acceptée ». Ils concluent qu’une taille plus imposante de l’échantillon fournirait « une preuve davantage solide que l’hypothèse nulle [statistique] est vraie » [nous soulignons].
Les auteurs décrivent correctement la relation qui existe entre la taille de l’échantillon et le pouvoir (statistique) d’une étude à rejeter l’hypothèse nulle lorsqu’elle est fausse. Cependant, c’est une erreur ou, à tout le moins, une maladresse sérieuse, de laisser croire qu’une étude puisse confirmer l’hypothèse nulleFootnote 51. David Streiner, professeur émérite à l’université McMaster, explique pourquoi avec humourFootnote 52 :
In Philosophy 101, we learned that, if Person A posits the existence of some phenomenon, it is incumbent on Person A to prove its existence rather than it being Person B’s job to disprove it. For example, if I assert that there are pink unicorns with purple polka dots hiding deep in the forest, I cannot simply say, “Well, prove that they don’t exist.” For the scientific world to accept my claim, I have to bring one back, dead or alive.
Et, plus loin,
In [null-hypothesis significance testing], if P is greater than 0.05, we do not say that we can accept (or prove) the null hypothesis; rather, we use the convoluted locution that we “have failed to disprove the null”.
The reason for this, […], harkens back to David Hume and the philosophy of science, which asserts that we cannot prove the nonexistence of something […]. To use our original example, no one has ever seen such a unicorn (at least while sober), but we cannot prove that it does not exist. Although it is highly unlikely, a unicorn may walk out of the forest tomorrow […].
En introduction au Manuel de l’INM (page 14), la très honorable Beverley M McLachlin, alors juge en chef du Canada, écrit qu’il « constitue un pas important » pour « apprivoiser la science de façon à renforcer notre système judiciaire et les valeurs fondamentales qu’il prône ». Sans vouloir manquer de respect à l’égard des auteurs, nous croyons que des passages du Manuel mériteraient d’être corrigés. Les passages erronés que nous avons mis en relief nous semblent être davantage que de simples glissements sémantiques.
2.2. Le recours à l’expertise statistique
Doutant que la formation à elle seule suffise à éviter les erreurs découlant de mésusage des règles probabilistes, certains auteurs préconisent d’accroître plutôt la présence d’experts en statistique dans les procédures judiciaires : « [J]ustice may be better served if [statisticians] were asked to review the calculations prior to trial »Footnote 53. Une personne formée dans cette discipline pourrait agir seule (2.2.1) ou faire partie d’une structure consultative située en marge du système judiciaire (2.2.2).
2.2.1. Contribution d’un expert en statistique à la procédure judiciaire
Pour un litige en particulier, l’expert pourrait être choisi par le juge des faits, dans une liste de personnes ayant manifesté un intérêt pour ce rôle, et dont l’expertise et l’impartialité auraient préalablement été établies, comme cela se fait en France lorsqu’un litige nécessite le concours d’un expert scientifiqueFootnote 54. L’expert en statistique pourrait aussi être désigné conjointement par les deux parties, sur une base consensuelle. Cette façon de faire respecterait l’esprit du Code de procédure civile qui, depuis le 1er janvier 2016, favorise l’expertise commune aux parties (art. 148 (4), 158 (2) et 540 al. 2 C.p.c.).
L’expert pourrait intervenir en amont du procès, pour aider le juge à évaluer la recevabilité d’une preuve scientifique avant l’examen de sa valeur probante. L’expert pourrait alors commenter la validité d’une donnée que l’une des parties souhaite présenter et, s’il y a lieu, vérifier si les calculs effectués respectent les règles applicables. À la demande du juge ou de l’une des parties, il pourrait aussi intervenir pendant le procès, pour favoriser une meilleure compréhension de l’information scientifique. Il ne s’agirait pas, pour l’expert, de donner des avis juridiques, car il dépasserait alors son champ de compétence, mais plutôt de traduire une preuve scientifique en des termes plus concrets pour les acteurs impliqués.
Andretta et ses collaborateurs ont proposé une grille pour aider un juge à évaluer une donnée empirique tirée d’une publication scientifiqueFootnote 55. Après avoir répertorié les erreurs statistiques parfois commises par les tribunaux, ils ont dressé une liste de 19 items qu’ils considèrent comme essentiels pour juger de la validité d’une statistique présentée en cour. Exigeant un bon niveau de connaissance en statistique, la grille d’analyse n’a pas été conçue pour être utilisée par un juge de façon autonome, mais plutôt pour faciliter ses échanges avec un statisticien. Bien qu’il s’agisse d’un outil prometteur pour les tribunaux, la grille a fait l’objet de peu d’épreuves de validation à ce jour. Aussi, comme le reconnaissent les auteurs eux-mêmes, aucun item de la grille ne concerne le théorème de Bayes, lequel pourrait connaître une utilisation accrue en cour dans le futur.
Comme les experts mandatés par des parties adverses peuvent parvenir à des conclusions divergentes quant à la validité d’une preuve scientifique, il pourrait être judicieux de recourir plutôt à un panel d’experts. Ce modèle, inspiré du hot-tubbing mis en place en Australie et fondé sur des pratiques de collaboration issues du milieu scientifiqueFootnote 56, favoriserait une approche plus objective et concertée de l’évaluation de la preuve. Le panel serait alors chargé de produire un rapport commun, qui ferait état des éléments consensuels et des divergences résiduelles. Cette procédure pourrait contribuer à améliorer la qualité de la preuve d’experts présentée devant les tribunaux, en plus de réduire les délais et les coûts inhérents au déroulement d’une instanceFootnote 57.
2.2.2. Création d’instances scientifiques consultatives
Expert en mégadonnées et journaliste indépendant, Nick Thieme suggère l’idée de créer une instance constituée de statisticiens dont le rôle serait d’apprécier la qualité de la preuve scientifique avant qu’elle ne soit présentée en cour : « What if there were to be an Inspector General-like body tasked with overseeing statistical arguments in legal settings? »Footnote 58 Il justifie sa proposition par une analogie avec la US Food and Drug Administration Footnote 59 :
Not all doctors are intimately familiar with the chemical structure of the medicines they prescribe because, frankly, chemistry is not their primary concern. For that reason, doctors rely on the chemists at the Food and Drug Administration to classify drugs and drug interactions as safe or not. A hypothetical statistical legal agency could do the same.
On peut aussi y voir une analogie avec les comités d’évaluation médicale chargés, au Québec, d’étudier les demandes soumises au Programme d’indemnisation des victimes d’une vaccination Footnote 60. Pierre d’assises du Programme, ces comités sont composés d’un médecin nommé par le ministre de la Santé et des Services sociaux, d’un médecin nommé par le réclamant et d’un troisième médecin nommé par les deux premiers. Au besoin, le comité peut consulter d’autres experts pour l’aider à formuler ses recommandations au ministreFootnote 61. La décision d’indemniser ou non le réclamant revient au ministre, après examen des recommandations du comité. La façon dont les membres sont nommés (par chacune des parties) fait de ces comités un modèle intéressant à considérer pour l’évaluation de données scientifiques soumises en preuve. En outre, leur rôle consultatif (qui laisse au ministre la décision finale) devrait atténuer la crainte que le pouvoir judiciaire soit délégué à la communauté scientifique.
Partant de l’hypothèse que le rehaussement des compétences scientifiques des acteurs juridiques par la formation n’est pas une panacée, nous avons exposé dans cette seconde sous-section quelques mécanismes par lesquels des statisticiens pourraient mettre leur expertise au service des cours de justice. Fondés sur une approche collaborative, ces mécanismes permettraient à des membres de deux communautés, l’une scientifique, l’autre juridique, de tisser des liens plus étroits, au bénéfice de la justice.
Conclusion
Selon Chaffai-Parent et SarrazinFootnote 62, « [l]a société entretient une dépendance grandissante aux savoirs scientifiques […] [dont] l’introduction […] devant les tribunaux au moyen d’experts est devenue indispensable » à la recherche de la vérité. Dans cet essai, nous avons donné quelques exemples de mésusage de statistiques et de probabilités qui ont conduit des juges et des jurys à prendre de mauvaises décisions. Nous avons souligné le potentiel du théorème de Bayes pour limiter ces situations, à condition de disposer des outils nécessaires à son application. Enfin, nous avons fait valoir la nécessité de rehausser la formation des juristes aux fondements de la statistique, et examiné différents moyens par lesquels les statisticiens intéressés par la sphère juridique pourraient y jouer un rôle élargi. Il s’agit, en quelque sorte, d’un plaidoyer pour le rapprochement de deux disciplines qui n’ont pas une longue expérience de collaboration.
Le théorème de Bayes est considéré par plusieurs comme une méthode logique et efficace pour combiner des éléments de preuve et contrer les raisonnements erronés en contexte d’incertitudeFootnote 63. L’enthousiasme pour cette approche doit toutefois être tempéré par les défis que pose son application.
Premier défi : l’approche bayésienne nécessite que des valeurs numériques soient attribuées à différentes probabilités. Ces valeurs pourront provenir d’études épidémiologiques. Dans l’affaire Benhaim, par exemple, il est vraisemblable que des écrits scientifiques fournissent une bonne estimation de la probabilité que le volume d’un nodule augmente en un an (E2) ou qu’un cancer pulmonaire soit diagnostiqué tardivement (E4). Dans d’autres situations, les valeurs requises devront être estimées subjectivementFootnote 64. Elles pourront alors varier d’un expert à l’autre et affecter le résultat final, surtout si les preuves sont nombreuses. Meesters et collaborateurs le soulignent : « The more sophisticated the analysis, the more subjective elements it seems to contain, and hence the more controversial are its conclusions »Footnote 65. Dahlman note, par ailleurs, que la formulation mathématique d’un témoignage peut donner une fausse impression d’objectivité et de certitude, alors qu’elle repose sur des estimations subjectives comportant une part considérable d’incertitudeFootnote 66.
Second défi : des biais cognitifs peuvent affecter l’estimation subjective d’une probabilité par un expert ou son interprétation par des juges et des jurésFootnote 67. En outre, des recherches suggèrent que les gens peinent à bien comprendre les informations statistiques et sous-estiment les preuves de cette natureFootnote 68. À ces considérations s’ajoute le défi d’intégrer correctement une donnée statistique aux éléments de preuve qualitatifs qui n’ont pas pu être chiffrésFootnote 69.
La notion de biais cognitifs réfère à des influences qui agissent sur un individu sans qu’il en ait conscience, ce qui les rend difficiles à reconnaître et à contrôlerFootnote 70. Des stratégies ont été proposées pour atténuer leurs effets, par exemple, recourir à des experts indépendants qui ne sont associés à aucune des parties au litigeFootnote 71 ou utiliser une probabilité consensuelle établie par un groupe d’expertsFootnote 72. La formation constitue un autre moyen pour sensibiliser les acteurs juridiques aux effets des biais cognitifs sur la prise de décisionFootnote 73. Des recherches sont toutefois nécessaires pour évaluer l’efficacité des méthodes d’atténuation des biais et pour déterminer dans quelle mesure les résultats de recherche, qui reposent souvent sur des procès simulés, sont transposables à la salle d’audienceFootnote 74.
Concernant la seconde partie de cet essai, des recherches sont aussi nécessaires pour identifier la meilleure manière d’accroître la littéracie des acteurs juridiques en statistique ou de faciliter l’intégration de statisticiens dans les procédures judiciaires. Quelles sont les connaissances statistiques minimales à acquérir? Faut-il privilégier une exposition obligatoire aux notions probabilistes via les programmes de 1er cycle universitaire en droit ou suffit-il d’offrir des ateliers de formation continue et des manuels d’autoapprentissage qui traitent de ces notions? Quel serait l’attrait de ces stratégies éducatives pour les juristes, notamment pour ceux que les mathématiques rebutent? Si la participation de personnes expertes en statistique était systématiquement requise dans les procès où des probabilités pourraient jouer un rôle déterminant, devraient-elles agir seules ou au sein d’une structure consultative? Comment s’assurer que les statisticiens participants ont les habiletés nécessaires pour expliquer simplement des notions complexes? Leur présence au tribunal est-elle susceptible d’alourdir les procédures sans bénéfice tangible?
Voilà autant de questions de recherche dont les réponses pourraient contribuer à accroître la qualité des décisions judiciaires qui reposent en partie sur des probabilités et à rehausser la confiance de la population dans les systèmes de justice.


 Open access

